Read in English: Delta and Lakeflow: where bad data passes with no error
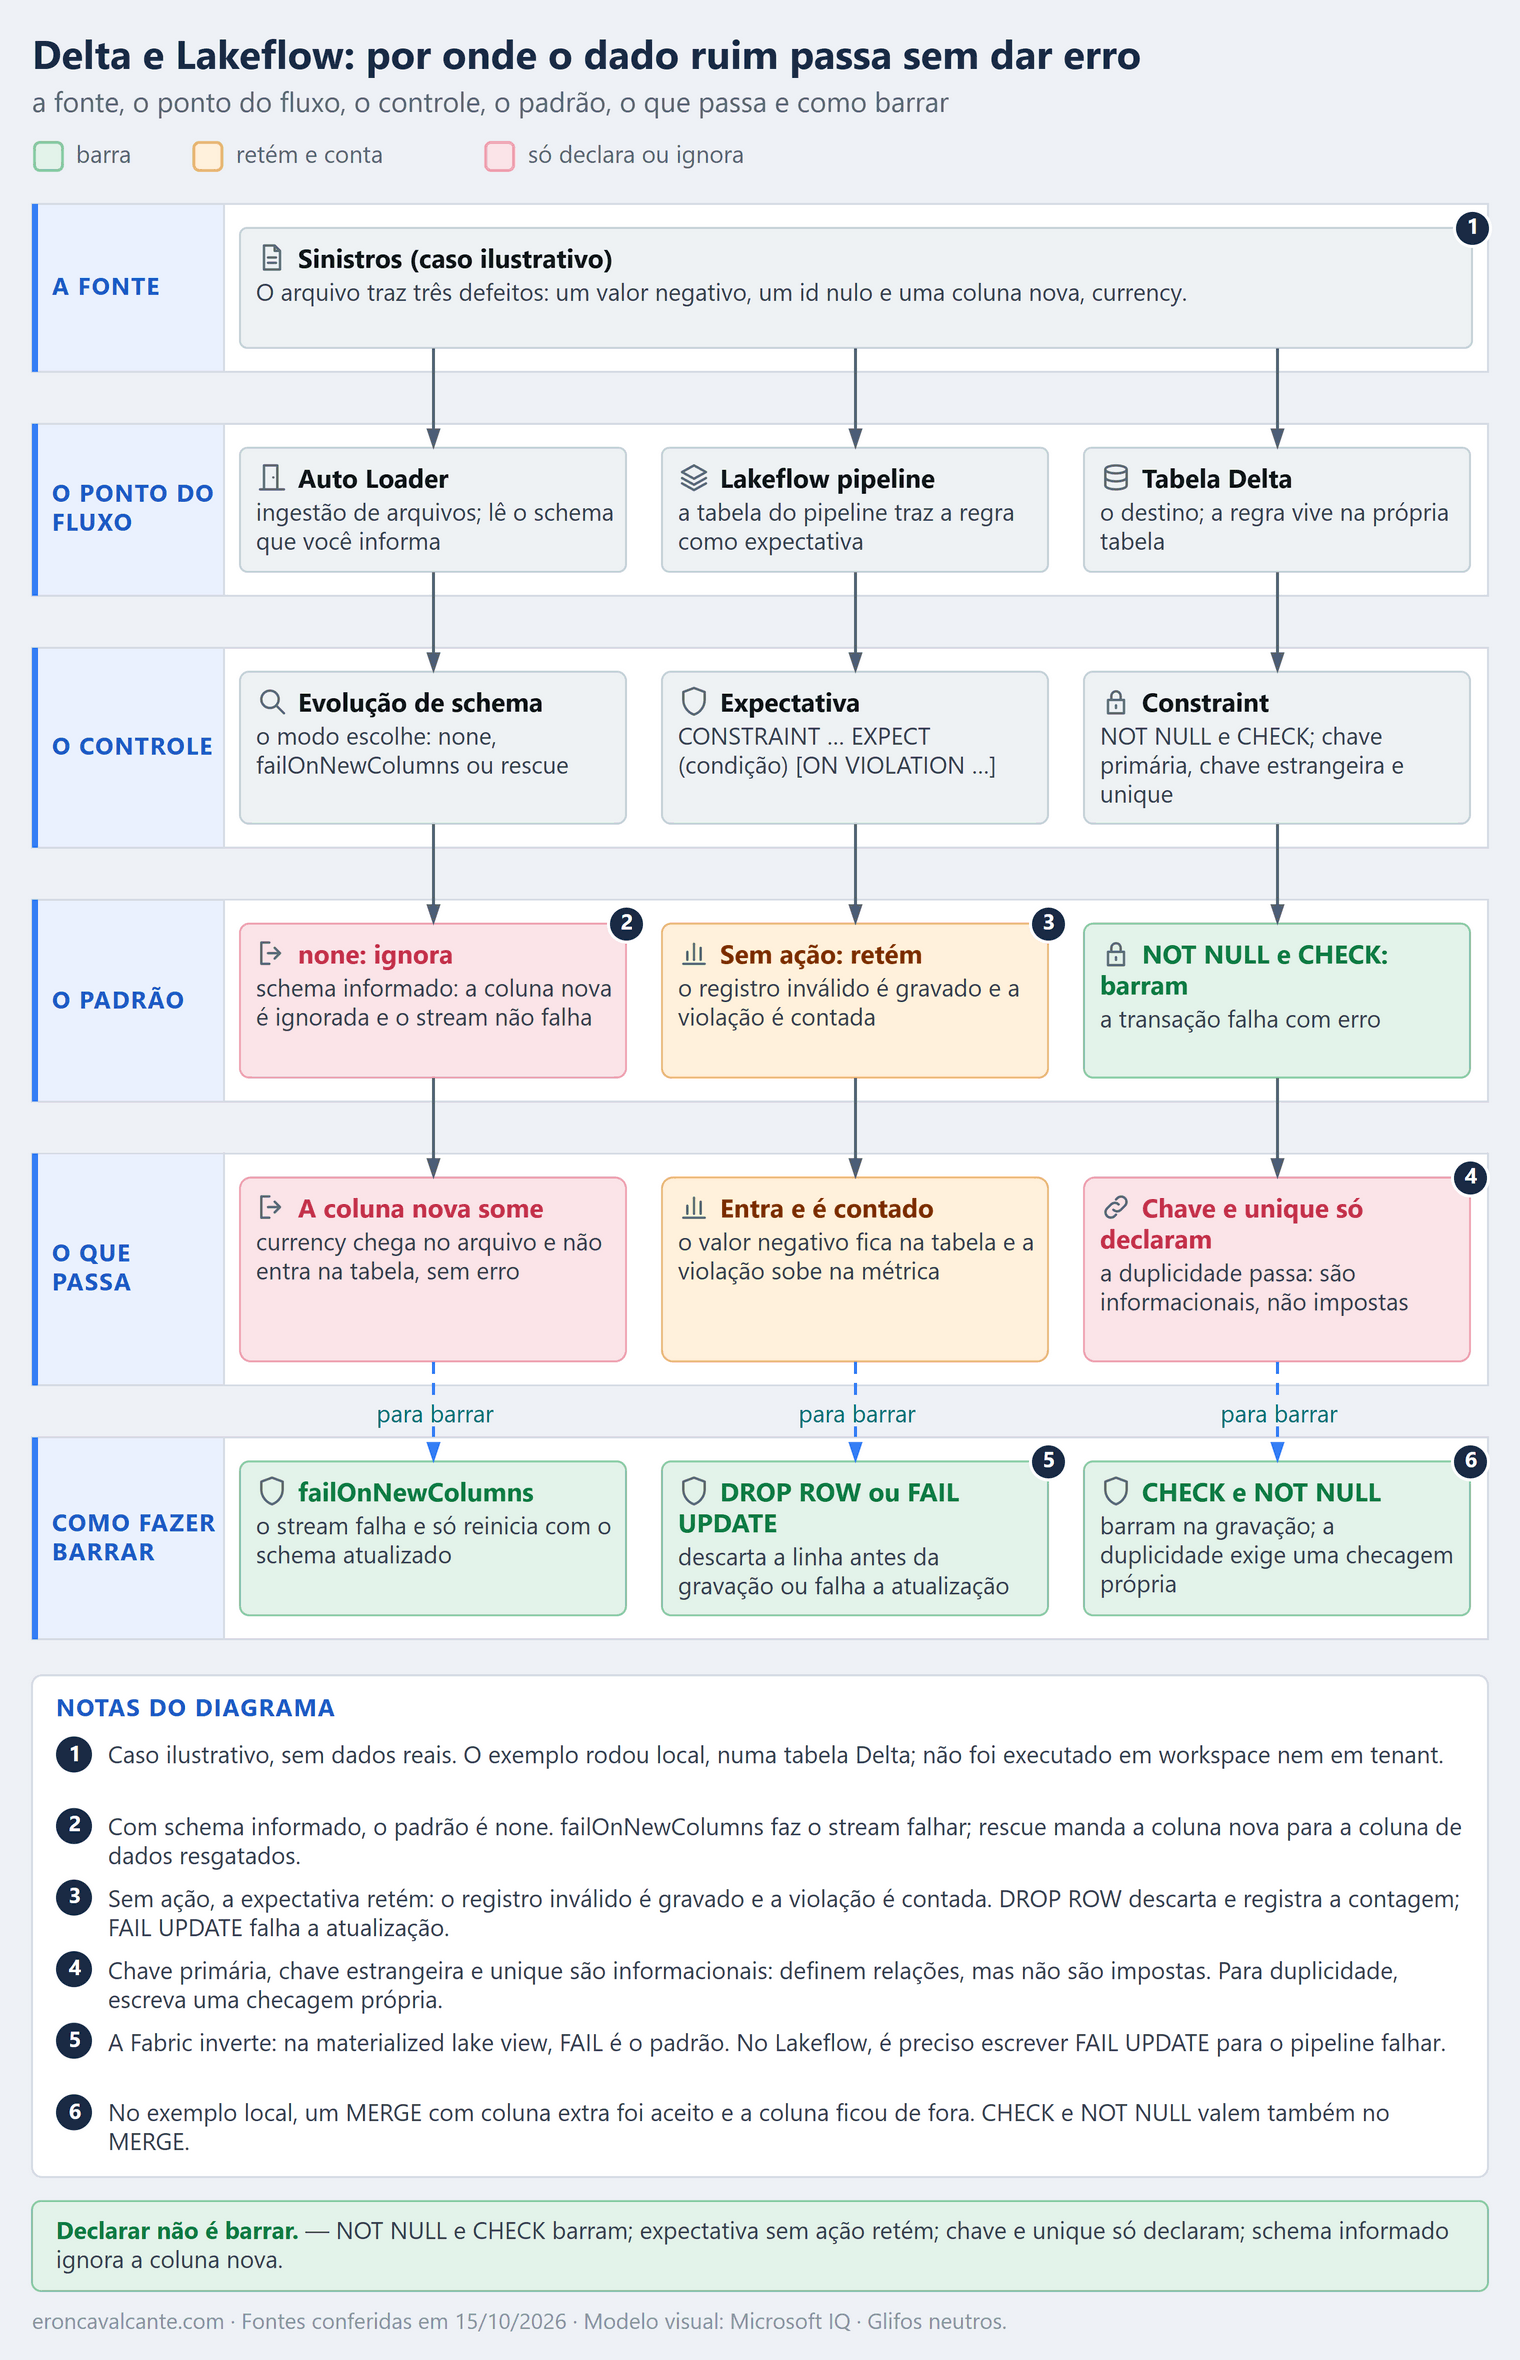
Imagine um pipeline de sinistros em que o painel de qualidade está verde. A regra “valor pago maior ou igual a zero” foi declarada, e mesmo assim um sinistro com valor negativo entrou na tabela. Na mesma semana, o sistema de origem passou a enviar uma coluna nova, currency, e ela simplesmente sumiu, sem erro. Nenhum dos dois defeitos derrubou o pipeline. O caso é ilustrativo, mas o padrão é real: declarar uma regra e barrar o dado são coisas diferentes, e cada camada do Databricks e do Fabric escolhe o seu comportamento.
Declarar não é barrar
O que é um contrato de qualidade na entrada do dado?
É a lista do que o dado precisa cumprir antes de ser gravado, somada ao que acontece quando ele não cumpre: barrar, reter e contar, descartar ou só declarar. Não é um produto; é uma decisão de arquitetura que cada camada responde de um jeito.
O artigo sobre ontologia e dado governado tratou do sentido do dado e do contexto. Aqui o recorte é a conformidade: o que a camada de gravação faz quando o dado viola a regra.
| Camada | Padrão quando o dado viola | Efeito |
|---|---|---|
Delta: NOT NULL e CHECK |
Barra | A transação falha com erro |
Delta: chave primária, chave estrangeira e unique |
Só declara | Não são impostas |
| Lakeflow: expectativa sem ação | Retém | O registro inválido é gravado no destino |
Lakeflow: ON VIOLATION DROP ROW |
Descarta | O registro some antes da gravação |
Lakeflow: ON VIOLATION FAIL UPDATE |
Barra | A atualização falha |
Delta: MERGE com INSERT * e coluna extra na origem |
Ignora a coluna nova | A gravação é aceita sem a coluna |
| Auto Loader com schema informado | Ignora a coluna nova | O stream não falha |
| Auto Loader sem schema informado | Evolui o schema (addNewColumns) |
O stream para e, no reinício, segue com a coluna nova |
| Fabric: materialized lake view | Barra, porque FAIL é o padrão |
A atualização para na primeira violação |
Leitura das fontes: 15/10/2026. O quadro resume a documentação lida nessa data. O exemplo da seção prática foi executado localmente; nada aqui foi medido em um workspace Databricks ou em um tenant Fabric.
O problema que resolve
Quando a regra só existe no papel, o erro aparece longe da origem: no relatório que não fecha, na métrica que muda sem explicação. O mapa acima evita três erros: supor que toda regra declarada barra, tratar descarte e retenção como se fossem a mesma coisa e esquecer as portas que não passam pela regra, como o MERGE e a coluna nova no ingestor.
Como funciona — passo a passo
- Liste os defeitos que importam: valor negativo, identificador nulo, coluna nova, duplicidade.
- Decida o que cada defeito merece: barrar, reter em quarentena, reter e contar, ou descartar. É decisão de negócio, não de ferramenta.
- Ponha cada controle na camada que o impõe:
NOT NULLeCHECKna tabela Delta, expectativa no pipeline Lakeflow,failOnNewColumnsno Auto Loader. - Teste as portas laterais: MERGE, append com coluna nova, modo de evolução do Auto Loader e reprocessamento.
- Leia a contagem de registros retidos ou descartados e transforme-a em alerta. Uma contagem que ninguém lê não protege nada.
- Marque o que só é informacional, como chave primária e
unique, para ninguém tratá-lo como barreira.
O que barra: constraints e schema enforcement no Delta
No Delta, NOT NULL e CHECK são constraints impostas: segundo a documentação do Databricks, quando uma delas é violada, a transação falha com um erro. O Databricks também valida o schema na gravação: todas as colunas inseridas precisam existir na tabela de destino, e o exemplo da página falha ao inserir uma coluna desconhecida.
Há dois custos a conhecer. O primeiro: adicionar uma constraint eleva o protocolo de escrita da tabela quando a versão atual é menor que 3. Confira os clientes externos que gravam nela antes de aplicar. O segundo: ALTER TABLE ... ADD CONSTRAINT verifica todas as linhas existentes antes de aceitar o CHECK, e o mesmo vale ao adicionar NOT NULL. Em uma tabela que já recebeu dado ruim, a constraint não entra até o legado ser limpo, o que transforma a primeira aplicação em um pequeno projeto de saneamento.
-- Antes de aplicar, meça o legado que impediria a constraint
SELECT count(*) AS violacoes FROM claims WHERE paid_amount < 0;

ALTER TABLE claims ADD CONSTRAINT non_negative_amount CHECK (paid_amount >= 0);
ALTER TABLE claims ALTER COLUMN claim_id SET NOT NULL;
Chave primária, chave estrangeira e unique são constraints informacionais: definem relações entre campos e não são impostas. Quem espera barrar duplicidade com unique precisa de outra checagem. A própria página das constraints remete às expectativas do Lakeflow como conceito relacionado.
O que deixa passar: MERGE, Auto Loader e expectativa warn
MERGE com INSERT * e UPDATE SET *. A origem precisa ter todas as colunas do destino, e a imposição ignora colunas da origem que o destino não tem. No exemplo local, o MERGE com a coluna extra currency foi aceito e a coluna não entrou na tabela.
A porta também pode ser aberta de propósito. Segundo a referência de sintaxe do MERGE, no Databricks Runtime 15.2 ou superior, MERGE WITH SCHEMA EVOLUTION atualiza o schema da tabela de destino para acompanhar a origem, e a coluna nova passa a existir. São três comportamentos possíveis para o mesmo defeito, e só um deles deveria acontecer por acaso: nenhum.
| Escolha no MERGE | O que acontece com currency |
|---|---|
MERGE padrão com INSERT * |
A coluna é ignorada e some sem erro |
MERGE WITH SCHEMA EVOLUTION |
A coluna é adicionada ao destino |
| Teste de schema antes do MERGE | O job falha se a origem trouxer coluna fora do contrato |
Auto Loader com schema informado. O padrão de evolução é none: a coluna nova é ignorada e o stream não falha. Com failOnNewColumns, o stream falha e só reinicia depois de você atualizar o schema ou remover o arquivo ofensor. Com rescue, a coluna nova vai para a coluna de dados resgatados.
Sem schema informado, o padrão muda para addNewColumns: o stream para quando a coluna nova aparece, depois de o Auto Loader registrá-la no schema location; no reinício, segue com o schema atualizado. Ou seja, o mesmo Auto Loader ignora a coluna em um pipeline e interrompe o stream em outro, dependendo só de o schema ter sido informado.
Modo (cloudFiles.schemaEvolutionMode) |
Coluna nova chega | Quando é o padrão |
|---|---|---|
addNewColumns |
O stream para depois de atualizar o schema; no reinício, segue com ele | Sem schema informado |
none |
Ignorada; o stream segue | Com schema informado |
rescue |
Vai para a coluna de dados resgatados; o stream segue | — |
failOnNewColumns |
O stream falha até o schema ser atualizado ou o arquivo removido | — |
Para o caso de sinistros, em que a coluna nova precisa chamar atenção, a escolha explícita fica assim (trecho não executado):
(spark.readStream.format("cloudFiles")
    .option("cloudFiles.format", "json")
    .option("cloudFiles.schemaEvolutionMode", "failOnNewColumns")
    .schema("claim_id STRING, paid_amount DOUBLE, status STRING")
    .load("<caminho-da-origem>"))
Expectativa sem ação. Reter registros inválidos é o comportamento padrão, chamado warn na documentação: o registro inválido é gravado no destino. Com ON VIOLATION DROP ROW, ele é descartado antes da gravação e a contagem é registrada; com ON VIOLATION FAIL UPDATE, a atualização falha. Reter e contar pode ser a escolha certa, desde que alguém leia a contagem.
O Fabric escolheu outro padrão
Nas materialized lake views do Fabric, a ação padrão é FAIL: a atualização para na primeira violação, mesmo que você não a especifique. Com DROP, o processamento continua e os registros que violam a restrição são removidos; a visão de linhagem mostra a contagem. Se a mesma view define DROP e FAIL, FAIL prevalece.
É o inverso do padrão do Lakeflow: lá, a expectativa sem ação retém; aqui, a restrição sem ação interrompe. Quem leva uma regra de um lado para o outro herda um comportamento diferente sem mudar uma linha.
A precedência do FAIL tem uma consequência prática. No Lakeflow, cada expectativa tem a sua ação e elas convivem no mesmo dataset. Na view abaixo (trecho não executado, sintaxe da referência do Fabric), a intenção parece ser “barrar sinistro sem identificador e descartar valor negativo”, mas a documentação diz que, com as duas ações na mesma view, o FAIL prevalece:
CREATE OR REPLACE MATERIALIZED LAKE VIEW silver.claims_clean
(
  CONSTRAINT has_claim_id CHECK (claim_id IS NOT NULL) ON MISMATCH FAIL,
  CONSTRAINT non_negative_amount CHECK (paid_amount >= 0) ON MISMATCH DROP
)
AS SELECT claim_id, paid_amount, status FROM bronze.claims;
Leitura minha: se as duas ações forem necessárias, separe-as em duas views encadeadas, uma com DROP e outra com FAIL, em vez de confiar na combinação. Outro ponto: a linhagem mostra quantos registros foram descartados, não quais. Para guardar as linhas rejeitadas, aplique a mesma regra em uma etapa anterior que grave os inválidos em uma tabela própria.
Um caso de uso: sinistros na seguradora
O caso é ilustrativo: uma seguradora ingere sinistros e alimenta um painel de pagamentos. O artigo sobre a arquitetura medalhão mostra onde ficam as camadas; aqui o ponto é o que cada porta de entrada faz com o defeito.
| Defeito | Controle que barra | Sem o controle |
|---|---|---|
| Valor pago negativo | CHECK (paid_amount >= 0) no Delta ou FAIL UPDATE na expectativa |
Entra na tabela; com expectativa sem ação, entra e é contado |
| Sinistro sem identificador | NOT NULL em claim_id |
Entra uma linha sem identificador |
Coluna nova na origem (currency) |
failOnNewColumns no Auto Loader; o append no Delta já falha |
Com schema informado, o Auto Loader ignora; o MERGE ignora a coluna extra |
| Identificador duplicado | Checagem própria: unique e chave primária são informacionais |
Duas linhas para o mesmo sinistro |
Barrar, reter ou descartar: como decidir
A ferramenta executa a ação; quem escolhe é o negócio. Quatro perguntas resolvem a maior parte dos casos:
| Pergunta sobre o defeito | Se a resposta é sim | No caso de sinistros |
|---|---|---|
| Ele corrompe dinheiro, identidade ou obrigação regulatória? | Barrar (CHECK, NOT NULL, FAIL UPDATE) |
Valor pago negativo, sinistro sem claim_id |
| O registro tem valor, mas precisa de correção e reprocessamento? | Quarentena: separar em um caminho próprio, para correção | Sinistro com status desconhecido |
| O registro é ruído, sem valor de negócio? | Descartar e contar (DROP ROW) |
Linha de teste ou de heartbeat do sistema de origem |
| A regra é nova e ninguém sabe a taxa de violação? | Reter e contar (warn) por um ciclo, e então decidir |
Regra recém-criada de formato de CPF |
O erro mais comum é usar DROP ROW para um defeito da primeira linha: o sinistro com valor negativo some do painel de pagamentos, a soma fecha e ninguém investiga. Descartar é adequado para ruído, não para dinheiro.
Na prática: o que a tabela Delta barra e o que aceita
Executei o exemplo abaixo localmente, com delta-rs (deltalake 1.6.6 e pyarrow 25.0.1). Ele não rodou em um workspace Databricks nem em um tenant Fabric: mostra o comportamento de uma tabela Delta com CHECK e NOT NULL. O que a documentação diz sobre MERGE, Auto Loader e expectativas fica citado, não reproduzido.
import json
import tempfile

import pyarrow as pa
from deltalake import DeltaTable, write_deltalake
from deltalake.exceptions import DeltaError

REQUIRED = pa.schema([
    pa.field("claim_id", pa.string(), nullable=False),
    pa.field("paid_amount", pa.float64()),
    pa.field("status", pa.string()),
])


def claims(rows, currency=None, schema=None):
    data = {
        "claim_id": pa.array([r[0] for r in rows], pa.string()),
        "paid_amount": pa.array([r[1] for r in rows], pa.float64()),
        "status": pa.array([r[2] for r in rows], pa.string()),
    }
    if currency:
        data["currency"] = pa.array([currency] * len(rows), pa.string())
    return pa.table(data, schema=schema)


def append(path, source):
    write_deltalake(path, source, mode="append")


def merge(path, source):
    (
        DeltaTable(path)
        .merge(source, "t.claim_id = s.claim_id", source_alias="s", target_alias="t")
        .when_matched_update_all()
        .when_not_matched_insert_all()
        .execute()
    )


def try_write(path, source, write):
    try:
        write(path, source)
        verdict = "accepted"
    except DeltaError:
        verdict = "blocked"
    table = DeltaTable(path)
    return {
        "verdict": verdict,
        "rows": table.to_pyarrow_table().num_rows,
        "version": table.version(),
        "source_columns": source.num_columns,
        "table_columns": len(table.schema().fields),
    }


def make_table(folder, constrained=True):
    path = f"{folder}/claims"
    first = claims([("C1", 100.0, "paid"), ("C2", 50.0, "open")], schema=REQUIRED)
    write_deltalake(path, first)
    if constrained:
        DeltaTable(path).alter.add_constraint({"non_negative_amount": "paid_amount >= 0"})
    return path


def run():
    with tempfile.TemporaryDirectory() as folder:
        path = make_table(folder)
        return {
            "check_on_append": try_write(path, claims([("C3", -50.0, "paid")]), append),
            "null_id_on_append": try_write(path, claims([(None, 10.0, "paid")]), append),
            "new_column_on_append": try_write(path, claims([("C4", 10.0, "paid")], "BRL"), append),
            "new_column_on_merge": try_write(path, claims([("C5", 30.0, "open")], "BRL"), merge),
            "check_on_merge": try_write(path, claims([("C6", -5.0, "paid")]), merge),
        }


print(json.dumps(run(), indent=2))
A saída, copiada da execução:
{
  "check_on_append": {
    "verdict": "blocked",
    "rows": 2,
    "version": 1,
    "source_columns": 3,
    "table_columns": 3
  },
  "null_id_on_append": {
    "verdict": "blocked",
    "rows": 2,
    "version": 1,
    "source_columns": 3,
    "table_columns": 3
  },
  "new_column_on_append": {
    "verdict": "blocked",
    "rows": 2,
    "version": 1,
    "source_columns": 4,
    "table_columns": 3
  },
  "new_column_on_merge": {
    "verdict": "accepted",
    "rows": 3,
    "version": 2,
    "source_columns": 4,
    "table_columns": 3
  },
  "check_on_merge": {
    "verdict": "blocked",
    "rows": 3,
    "version": 2,
    "source_columns": 3,
    "table_columns": 3
  }
}
| Caso | Veredito | Linhas na tabela | Versão |
|---|---|---|---|
| Valor negativo em append | Barrado | 2 | 1 |
| Identificador nulo em append | Barrado | 2 | 1 |
| Coluna nova em append | Barrado | 2 | 1 |
| Coluna nova em MERGE | Aceito | 3 | 2 |
| Valor negativo em MERGE | Barrado | 3 | 2 |
A tabela começa com duas linhas: a versão 0 é a gravação inicial e a 1, a constraint. Os três primeiros casos foram barrados e a tabela não mudou. O MERGE com currency foi aceito, criou a versão 2 com uma linha nova e deixou a coluna de fora: a tabela segue com três colunas. O último caso mostra que o CHECK também vale dentro do MERGE. Os erros observados foram DeltaError com “1 rows failed validation check” para CHECK e NOT NULL, e SchemaMismatchError para a coluna nova no append.
No Lakeflow, o mesmo contrato vira expectativa. Este trecho não foi executado: adapta ao caso a sintaxe mostrada na documentação, seguindo o quadro de decisão acima. Os dois defeitos que tocam dinheiro e identidade barram; o ruído do sistema de origem é descartado e contado.
CREATE OR REFRESH STREAMING TABLE claims_clean(
  CONSTRAINT has_claim_id        EXPECT (claim_id IS NOT NULL)     ON VIOLATION FAIL UPDATE,
  CONSTRAINT non_negative_amount EXPECT (paid_amount >= 0)         ON VIOLATION FAIL UPDATE,
  CONSTRAINT not_heartbeat       EXPECT (status <> 'heartbeat')    ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.claims);
Quarentena: reter sem contaminar
Entre barrar tudo e descartar em silêncio há um meio-termo que a documentação descreve entre os padrões avançados de expectativas: marcar o registro inválido e separar os caminhos: uma view lê os válidos e outra os inválidos, ambas sobre a mesma tabela marcada. O pipeline não para, o painel recebe só o que é válido e as linhas inválidas seguem por um caminho separado, para correção. A página não registra o motivo da rejeição; gravar os inválidos em uma tabela própria é adaptação minha.
O trecho abaixo não foi executado; segue a estrutura do padrão documentado, adaptada por mim (coalesce e tabelas para os dois caminhos), aplicada aos sinistros:
from pyspark import pipelines as dp
from pyspark.sql.functions import expr

rules = {
    "has_claim_id": "claim_id IS NOT NULL",
    "non_negative_amount": "paid_amount >= 0",
}
# coalesce(..., false): uma comparação com NULL também vai para a quarentena
quarantine_rule = "NOT coalesce(({0}), false)".format(" AND ".join(rules.values()))

@dp.table(name="claims_flagged")
@dp.expect_all(rules)  # sem ação: retém e conta, por regra
def claims_flagged():
    return (
        spark.readStream.table("raw.claims")
        .withColumn("is_quarantined", expr(quarantine_rule))
    )

@dp.table(name="claims_valid")
def claims_valid():
    return spark.readStream.table("claims_flagged").filter("NOT is_quarantined")

@dp.table(name="claims_quarantine")
def claims_quarantine():
    return spark.readStream.table("claims_flagged").filter("is_quarantined")
O coalesce é uma escolha deliberada: em SQL, paid_amount >= 0 com paid_amount nulo resulta em NULL, a negação de NULL continua NULL, e os dois filtros deixam a linha de fora. Sem esse cuidado, o registro não aparece nem na tabela válida nem na quarentena: a quarentena ganha a sua própria porta lateral.
Duplicidade: a checagem que a chave não faz
Como chave primária e unique não são impostas, a duplicidade precisa de uma validação própria. Um dos padrões avançados da documentação usa uma materialized view auxiliar que conta ocorrências por chave. No exemplo Python da página, ela falha a atualização (expect_or_fail) quando uma chave se repete; a versão SQL abaixo é adaptação minha (trecho não executado):
CREATE OR REFRESH MATERIALIZED VIEW claims_pk_check(
  CONSTRAINT unique_claim_id EXPECT (num_entries = 1) ON VIOLATION FAIL UPDATE
) AS
SELECT claim_id, count(*) AS num_entries
FROM claims_clean
GROUP BY claim_id;
A view não impede a linha duplicada de entrar em claims_clean; ela faz falhar o fluxo da própria view, mas não segura as demais tabelas. Para barrar o que vem depois, separe a validação e o trabalho a jusante em pipelines distintos, orquestrados por um job em que a tarefa a jusante dependa da de validação. Se a duplicidade não pode nem chegar à tabela, o lugar dela é um MERGE pela chave, em vez de append.
Lendo a contagem
“Reter e contar” só protege se a contagem for lida. No Lakeflow, os resultados das expectativas ficam no event log do pipeline, nos eventos do tipo flow_progress. A documentação recomenda hoje a system table pipeline_events, que reúne os eventos de todos os pipelines dos workspaces da região e está em Beta; o event log por pipeline continua disponível pela função event_log().
A consulta abaixo usa o formato documentado para extrair registros aprovados e reprovados por expectativa, mas soma todas as atualizações guardadas no event log; a documentação filtra a última atualização por origin.update_id e avisa que alguns datasets podem não ter métricas (trecho não executado):
SELECT
  e.dataset,
  e.name                 AS expectation,
  SUM(e.passed_records)  AS passed,
  SUM(e.failed_records)  AS failed
FROM (
  SELECT explode(
    from_json(
      details:flow_progress:data_quality:expectations,
      'array<struct<name: string, dataset: string, passed_records: int, failed_records: int>>'
    )
  ) AS e
  FROM event_log('<pipeline-id>')
  WHERE event_type = 'flow_progress'
)
GROUP BY e.dataset, e.name
ORDER BY failed DESC;
Na system table pipeline_events, a documentação lê details com variant_get; esta consulta precisa de adaptação.
O passo seguinte é transformar a consulta em alerta, com um limite por expectativa, ou usar event hooks, que a página de monitoramento cita para executar ações, como enviar alertas, quando eventos são registrados. No Fabric, a contagem de descartes aparece na linhagem da materialized lake view.
Onde o agente entra
Um agente que consulta essa tabela responde com a mesma fluência quando o dado está certo e quando não está. Essa ponte é leitura minha, não afirmação da documentação: se o valor negativo entrou, o agente não tem como saber. A página do Genie Agent descreve um ambiente de domínio em que o time de dados configura dado confiável, métricas e regras de negócio; o que torna o dado confiável acontece antes, na gravação.
O data profiling, que antes se chamava Lakehouse Monitoring, fornece estatísticas resumidas da tabela. Pelo que a página descreve, ele mede. Que ele não bloqueia a gravação também é leitura minha. Por isso a ordem importa: a constraint e a expectativa decidem o que entra; o profiling observa o que entrou; e o agente deveria consultar só a tabela que passou pelas duas, como claims_valid, nunca a de quarentena.
Boas práticas para produção
- Declare a ação de cada regra. Expectativa sem ação retém; se a intenção é barrar, escreva
FAIL UPDATE. - Barre na tabela o que não pode entrar.
NOT NULLeCHECKvalem para toda gravação, inclusive MERGE, como o exemplo local mostrou. - Trate chave e
uniquecomo documentação, não como controle, e verifique duplicidade com uma checagem própria. - Fixe o comportamento da coluna nova. Com schema informado, o Auto Loader ignora; escolha
failOnNewColumnsourescuede propósito. - Use quarentena para o que tem valor. Descartar é para ruído; registro com dinheiro ou obrigação vai para quarentena, separado do fluxo válido, para correção e reprocessamento.
- Limpe o legado antes da constraint.
ADD CONSTRAINTeSET NOT NULLvalidam as linhas existentes; meça as violações antes de aplicar. - Abra a porta do MERGE só de propósito.
WITH SCHEMA EVOLUTIONadiciona a coluna nova; o padrão a ignora. Nenhum dos dois deveria ser surpresa. - Leia a contagem. Reter ou descartar sem ninguém olhar a métrica só adia o problema. Transforme a consulta ao event log em alerta com limite por regra.
- Revise ao migrar de camada. O Lakeflow retém por padrão e o Fabric interrompe por padrão; no Fabric,
FAILprevalece sobreDROPna mesma view. - Versione as regras junto do pipeline. Expectativas são código; o artigo sobre Lakeflow como código mostra o caminho de deploy em que elas viajam com o repositório.
O que precisa estar de pé
A ordem abaixo é causal, não cronológica: cada estágio existe porque o anterior ficou de pé.
Fundação — cada regra tem uma ação declarada. Toda regra de qualidade na entrada diz se barra, retém ou descarta; o que precisa barrar vira NOT NULL, CHECK ou FAIL UPDATE; o que só declara, como chave e unique, está marcado como informacional.
Está de pé quando, para cada regra, alguém responde em um minuto se ela barra, retém ou só declara.
Produção com contexto — as portas laterais têm teste. MERGE, append com coluna nova e o modo de evolução do Auto Loader estão cobertos por teste, os registros com valor vão para quarentena, e a contagem de registros retidos ou descartados chega, como alerta, a quem pode agir.
Está de pé quando um registro retido ou descartado aparece em uma contagem que alguém lê e responde.
Escala e eficiência — o padrão vem no template. O template de pipeline do time traz as ações explícitas, os testes das portas laterais e a regra de que unique e chave primária não contam como controle.
Está de pé quando um pipeline novo chega a produção com as ações declaradas sem ninguém lembrar de pedir no review.
Perguntas frequentes (FAQ)
Chave primária e unique barram duplicidade no Delta?
Não. Na documentação do Databricks, chave primária, chave estrangeira e unique são informacionais: definem relações entre campos e não são impostas. Barre com NOT NULL e CHECK e verifique duplicidade com uma checagem própria.
A expectativa do Lakeflow barra o dado ruim?
Depende da ação. Sem ação, o registro inválido é gravado no destino; DROP ROW descarta antes da gravação; FAIL UPDATE impede a atualização.
O Auto Loader falha quando chega uma coluna nova?
Com schema informado, o padrão é none: a coluna nova é ignorada e o stream não falha. Com failOnNewColumns, o stream falha e só reinicia depois que você atualiza o schema ou remove o arquivo ofensor.
O Fabric trata a violação como o Lakeflow?
Não. Na materialized lake view, FAIL é o padrão e a atualização para na primeira violação; com DROP, os registros são removidos e a linhagem mostra a contagem. Se a mesma view tiver DROP e FAIL, o FAIL prevalece.
O MERGE pode adicionar a coluna nova em vez de ignorá-la?
Sim. No Databricks Runtime 15.2 ou superior, MERGE WITH SCHEMA EVOLUTION atualiza o schema do destino para acompanhar a origem. Sem essa cláusula, com INSERT * e UPDATE SET *, a coluna extra da origem é ignorada.
Como vejo quais registros foram descartados?
A contagem existe para warn e drop: no Lakeflow, no event log do pipeline (com fail, a atualização falha e não há métricas registradas; alguns datasets também não têm); no Fabric, na linhagem. As linhas em si não ficam guardadas com DROP. Para inspecioná-las, use o padrão de quarentena, que separa os inválidos em uma view sobre a tabela marcada.
Posso adicionar um CHECK em uma tabela que já tem dado ruim?
Não sem limpar antes. ALTER TABLE ... ADD CONSTRAINT verifica todas as linhas existentes e falha se alguma violar a regra.
Conclusão
Declarar uma regra não é barrar o dado. No Delta, NOT NULL e CHECK barram; no Lakeflow, a expectativa sem ação retém; chave e unique só declaram; o MERGE e o Auto Loader com schema informado ignoram a coluna nova; e o Fabric interrompe por padrão. Entre barrar e descartar existe a quarentena, e nenhuma delas vale sem alguém lendo a contagem. Antes de confiar no painel verde, pergunte de cada regra qual ação ela tem, por qual porta o dado pode contorná-la e quem é avisado quando isso acontece.
Referências oficiais
- Lakeflow pipelines: expectativas de qualidade.
- Lakeflow pipelines: recomendações e padrões avançados de expectativas.
- Lakeflow pipelines: event log.
- Lakeflow pipelines: monitorar e consultar eventos.
- Auto Loader: evolução de schema.
- Delta Lake no Databricks: schema enforcement.
- Constraints no Databricks.
- Cláusula ADD CONSTRAINT.
- MERGE INTO.
- Fabric: restrições de qualidade em materialized lake views.
- Fabric: referência Spark SQL de materialized lake views.
- Databricks: data profiling.
- Genie Agents no Databricks.
👉 Se você tem um pipeline em que a regra de qualidade está declarada, mas ninguém confirmou o que ela faz quando o dado viola, este é o momento de testar as portas laterais antes do próximo incidente. Quer trocar ideia sobre qualidade de dados no Databricks e no Fabric? Me chama no LinkedIn.