Read in English: Work IQ, Fabric and Foundry: three currencies in one solution
O agente responde uma pergunta, mas a conta atravessa serviços diferentes. O contexto vem do Microsoft 365, o número vem do Fabric e a resposta é produzida por um modelo no Foundry. Olhar apenas o consumo de tokens do modelo deixa parte do trabalho fora do orçamento. O problema aparece quando três equipes chegam à mesma reunião com três unidades diferentes e nenhuma consegue explicar o custo completo do fluxo.
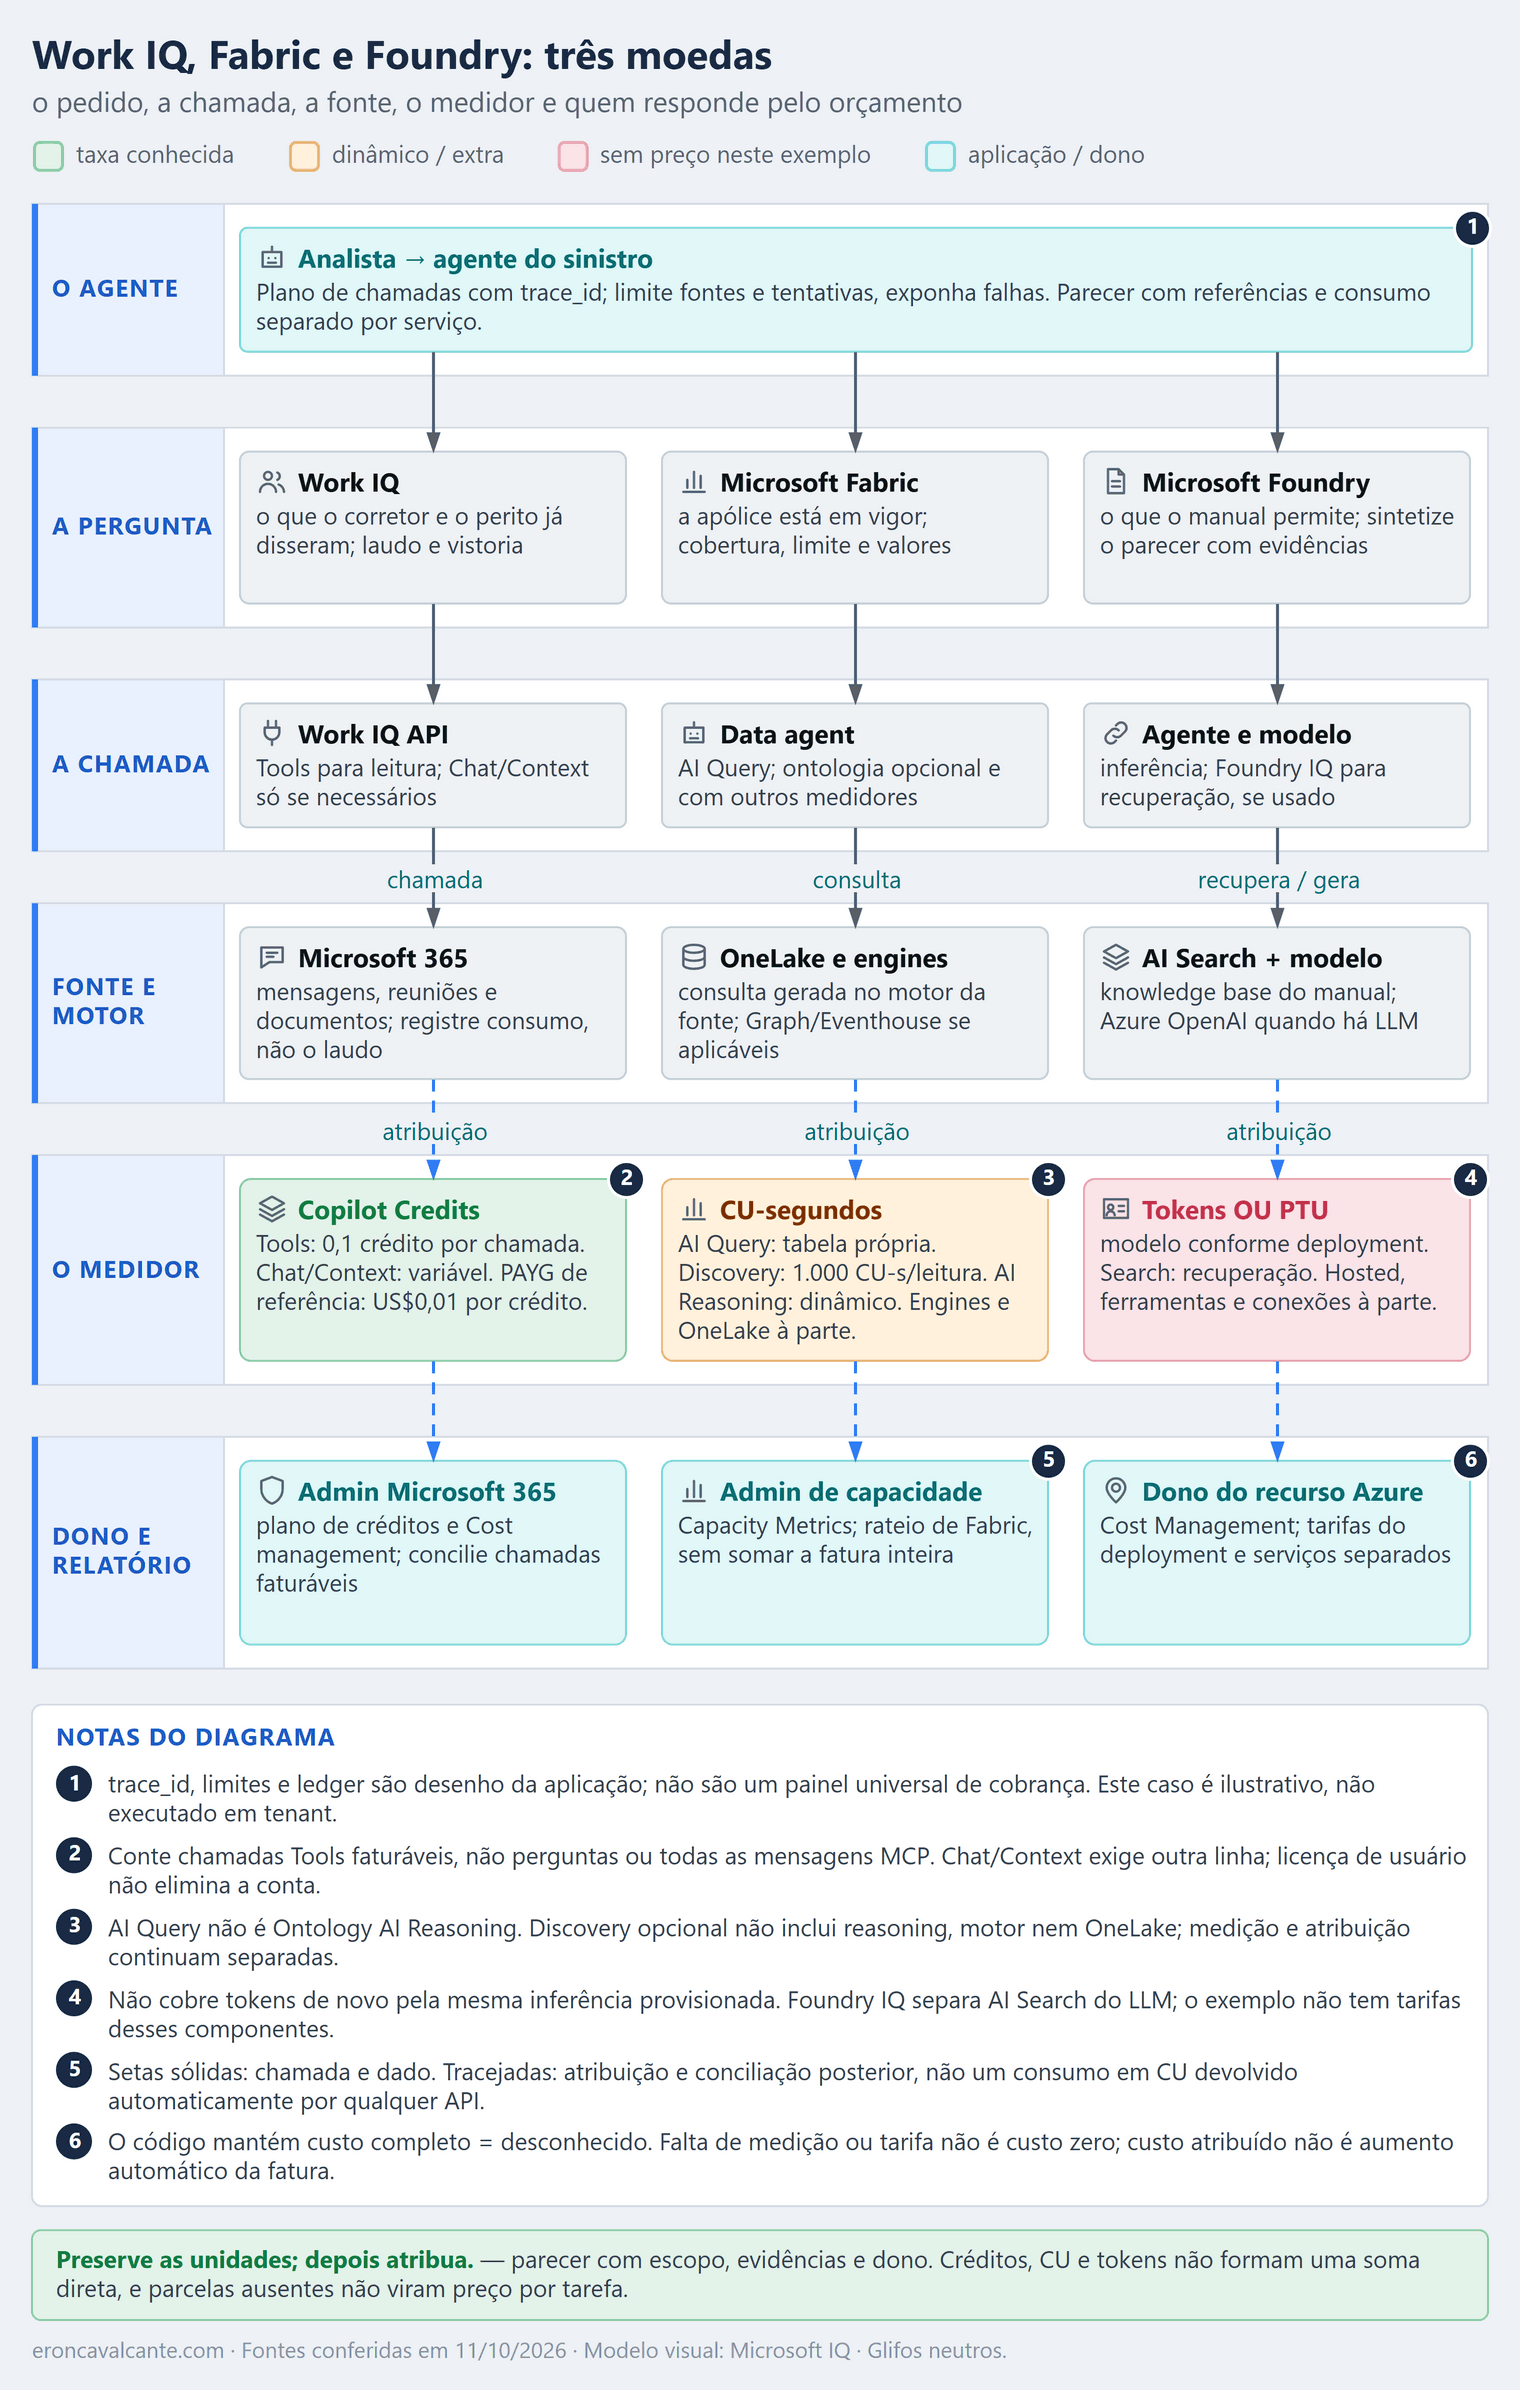
A moeda segue a chamada
O que é um mapa de cobrança do agente?
Relaciona operação, serviço, unidade de consumo e responsável pelo orçamento. É um artefato de arquitetura para agentes próprios, não um novo produto de cobrança.
O mapa do Microsoft IQ explicou qual pergunta cada camada responde. Aqui o recorte é a fronteira de cobrança: o que cada chamada consome e quem responde pelo orçamento. A comparação entre caching, batch e PTU ficou no artigo de FinOps de IA.
| Camada do fluxo | Unidade principal | Fronteira financeira |
|---|---|---|
| Work IQ API | Copilot Credits | Plano de cobrança e políticas no Microsoft 365 |
| Fabric data agent ou ontologia | CU-segundos de consumo | Capacidade Fabric e serviços cobrados separadamente |
| Modelo no Microsoft Foundry | Tokens ou PTU por hora | Deployment, recurso e modalidade contratada |
| Foundry IQ | Recuperação no AI Search; LLM quando usado | AI Search e Azure OpenAI; não uma moeda unificada |
Leitura das fontes: 11/10/2026. Os valores abaixo têm operação e fonte identificadas. Preço em moeda depende do plano, região e contrato; não existe uma cotação universal por “pergunta ao Microsoft IQ”.
O problema que resolve
Licença de usuário não paga automaticamente toda API; capacidade contratada não torna o workload sem custo. Uma resposta curta pode exigir muita recuperação, planejamento e consulta.
O mapa impede três erros: somar unidades incompatíveis, confundir custo atribuído com cobrança incremental e contar duas vezes trabalho já incluído em outro medidor. Também força uma decisão operacional: quem aprova ampliar consumo quando o agente cresce?
Como funciona — passo a passo
- Desenhe as chamadas necessárias para responder, incluindo recuperação, consultas, modelo, ferramentas e tentativas adicionais.
- Identifique o endpoint e o medidor de cada chamada. “Usa Fabric” não distingue data agent, ontologia e consulta ao warehouse.
- Separe consumo variável, capacidade contratada, armazenamento e licença de acesso.
- Converta as unidades com o preço aplicável ao plano; faça rateio explícito de capacidade compartilhada.
- Reconcilie o agregado com os relatórios de cada serviço e atribua um dono ao orçamento.
- Controle o fluxo na aplicação: limite tentativas, fontes e contexto sem transformar falha em resposta vazia.
Work IQ: licença de usuário não encerra a conta
O Work IQ API usa Copilot Credits. O overview distingue experiências do Copilot das chamadas de agentes próprios e de terceiros: a licença do Microsoft 365 Copilot não elimina a cobrança por uso desses agentes.
O Copilot Credits Guide, edição de outubro de 2026, separa dois componentes:
- Chat/Context: consumo variável de grounding, recuperação e raciocínio, influenciado por modelos, runtime, contexto e ferramentas.
- Tools API: componente estático de 0,1 Copilot Credit por chamada de API para ações e ferramentas.
O preço de referência do medidor pay-as-you-go no guia é US$0,01 por Copilot Credit. Assim, uma chamada coberta pelo componente estático equivale a US$0,001 nesse plano. Isso não é o preço de uma tarefa completa nem de qualquer ferramenta MCP de outro fornecedor.
O artigo sobre Work IQ MCP explica operação e path. Aqui, a consequência financeira é outra: se a aplicação faz várias chamadas faturáveis, conte cada uma. Se também chama Chat/Context, o componente variável não desaparece.
No P3, o compromisso é anual e créditos não usados expiram. Preço de varejo não é taxa efetiva de todo contrato; crédito não equivale a quantidade fixa de tokens.
Fabric: consumo em CU não é preço por resposta
A capacidade do Microsoft Fabric é um pool compartilhado. CU-segundos, ou CU-s, medem o consumo de operações; não são uma moeda que possa ser somada diretamente a Copilot Credits.
No Fabric data agent, a página por recurso publica as taxas da operação AI Query:
| Parte processada | Unidade | Consumo |
|---|---|---|
| Entrada não cacheada | 1.000 tokens | 100 CU-s |
| Entrada cacheada | 1.000 tokens | 10 CU-s |
| Saída | 1.000 tokens | 400 CU-s |
Instruções do agente, contexto e histórico entram na entrada; não conte apenas a pergunta digitada. A execução das consultas geradas é medida separadamente no engine correspondente. Contar só AI Query deixa de fora o trabalho de obter o dado.
A ontologia tem outra tabela
A nova experiência da ontologia, ainda em preview, tem três grupos de medidores:
- Ontology Discovery: 1.000 CU-segundos por leitura medida da definição.
- Ontology Logic and Operations: consumo de Eventhouse e Graph à taxa do item filho.
- Ontology AI Reasoning: consumo dinâmico, conforme tokens e recursos usados na tarefa.
Não aplique a tabela de AI Query à ontologia. A página atual não publica uma conversão fixa universal de tokens para Ontology AI Reasoning. Os quatro medidores da experiência antiga não descrevem a nova.
Discovery também não é preço por clique: com definição atual em cache, navegar normalmente não cria outra leitura. A interface pode reler após salvar ou atualizar e faz refresh automático aproximadamente a cada 20 minutos enquanto aberta. Fechar a aba evita leituras de refresh desnecessárias; isso não substitui controlar as chamadas da aplicação.
OneLake, armazenamento e operações de leitura/escrita têm cobranças separadas. Capacidade ociosa pode absorver consumo sem mudar imediatamente a fatura, mas usa folga de outros workloads. Escalar capacidade ou habilitar overage pode mudar o desembolso: consumo atribuído e custo incremental são perguntas diferentes.
Foundry: o modelo não é a conta inteira
No Microsoft Foundry, deployments standard cobram por tokens; deployments provisioned cobram por PTU por hora, ou usam reservas. O PTU alocado custa mesmo sem requisições. Tokens continuam úteis para medir utilização, mas não viram uma segunda cobrança por token da mesma inferência provisionada.
O Foundry Agent Service não acrescenta cobrança por criar ou executar agentes nativos de prompts e workflows. Isso não torna a solução gratuita: modelos, ferramentas e conexões podem cobrar. Hosted agents têm cobrança do compute de contêiner por hora; são outra modalidade.
Foundry IQ acrescenta a fronteira do AI Search
O Foundry IQ usa knowledge bases do Azure AI Search. A recuperação agêntica cobra tokens de recuperação na execução de subconsultas e no semantic ranking; se houver planejamento ou síntese com LLM, Azure OpenAI cobra seus tokens separadamente.
Não acrescente automaticamente uma tarifa de semantic ranker clássico por consulta à mesma recuperação agêntica: os modelos de cobrança são distintos. Inclua consultas clássicas realmente executadas fora desse pipeline.
O plano gratuito de recuperação tem franquia mensal. Esgotada a franquia, requisições que exigiriam consumo pago retornam erro de pagamento; o plano standard permite continuidade paga e requer Basic ou superior.
A partir da API de serviço 2026-04-01, o consentimento de cobrança de recuperação é controlado por knowledgeRetrieval, independentemente de semanticSearch. Migrar versão sem revisar isso pode interromper o fluxo.
Também separe disponibilidade de preço: a versão estável suporta recuperação mínima e extrativa com fontes GA; planejamento por LLM, síntese e capacidades não mínimas continuam em preview na documentação conferida.
Um caso de uso: o sinistro na seguradora
Retome o sinistro residencial por alagamento do artigo-modelo. O analista precisa conferir cobertura, vistoria e condições gerais. O agente prepara o parecer; o analista decide, sem ordem automática de pagamento.
| Parte do parecer | Chamada | Registro financeiro |
|---|---|---|
| Laudo e vistoria | Work IQ Tools | Chamadas faturáveis → créditos |
| Vigência, cobertura e valor | Fabric data agent | AI Query → CU-s; motor à parte |
| Manual e síntese | Foundry IQ + modelo | Search + tokens ou PTU; sem dupla conta |
O plano escolhe as fontes necessárias; não chama todas por padrão. A integração das ferramentas está no artigo-modelo. Aqui instrumentamos sua fronteira financeira, sem copiar laudos ou dados pessoais para o registro de consumo.
Um exemplo calculado, não uma fatura simulada
Imagine um agente próprio preparando um parecer para um analista. O exemplo é ilustrativo: cálculos conferidos contra a documentação, não executados em um tenant.
Work IQ. Suponha 20 chamadas faturáveis de Tools: 20 × 0,1 = 2 Copilot Credits. No PAYG de referência, 2 × US$0,01 = US$0,02. Qualquer Chat/Context adicional precisa de outra linha.
Fabric data agent. Suponha 2.000 tokens de entrada não cacheada e 500 de saída. A conta é (2.000 × 100 + 500 × 400) / 1.000 = 400 CU-s, ou aproximadamente 0,111 CU-hora, sem a execução das consultas.
Ontologia, se também consultada. Uma leitura medida da definição acrescenta 1.000 CU-s. O subtotal desses dois consumos seria 1.400 CU-s, aproximadamente 0,389 CU-hora. Não inclui raciocínio dinâmico, item filho nem OneLake.
Para ilustrar rateio, use uma taxa hipotética de US$0,18/CU-hora: 1.400 / 3.600 × US$0,18 = US$0,07 de custo atribuído. Não é cotação do seu contrato nem cobrança automática por chamada. Em uma capacidade contratada, o rateio precisa reconciliar custo amortizado, utilização e folga.
Foundry. Para inferência standard, mantenha tokens de entrada não cacheada, cacheada e saída separados e aplique as respectivas tarifas do modelo/deployment. Para PTU, atribua parcela do custo da capacidade no período. Acrescente AI Search e demais serviços efetivamente usados.
Custo atribuído ao fluxo =
  Work IQ convertido pelo plano de créditos
  + parcela da capacidade Fabric + cobranças separadas
  + modelo Foundry: tokens OU parcela do PTU
  + AI Search + ferramentas + armazenamento aplicáveis
Não publique “US$0,09 por parecer”: o exemplo tem parcelas ainda não calculadas. A unidade útil é custo atribuído a um fluxo com escopo declarado, não um número que finge incluir serviços ausentes.
Na prática: registrando o consumo do sinistro
Python 3.10+, somente biblioteca padrão. Salve como exemplo.py e execute python exemplo.py. Os contadores são ilustrativos, não respostas reais das APIs. tools_calls representa chamadas Tools faturáveis, não todas as mensagens MCP; tokens do modelo e custos sem tarifa ficam separados.
import json
from decimal import Decimal as D

COUNTERS = (
    "tools_calls", "fabric_uncached_tokens", "fabric_cached_tokens",
    "fabric_output_tokens", "discovery_reads", "foundry_uncached_tokens",
    "foundry_cached_tokens", "foundry_output_tokens",
)


def attribute_partial(trace_id: str, counters: dict[str, int],
                      model_mode: str) -> dict[str, object]:
    if not isinstance(trace_id, str) or not trace_id.strip():
        raise ValueError("A nonempty application trace_id is required")
    if set(counters) != set(COUNTERS) or any(
        type(value) is not int or value < 0 for value in counters.values()
    ):
        raise ValueError("Provide exactly the nonnegative integer counters")
    if model_mode not in {"standard", "provisioned"}:
        raise ValueError("Declare standard or provisioned model billing")

    credits = D(counters["tools_calls"]) * D("0.1")
    ai_query = (
        D(counters["fabric_uncached_tokens"]) * 100
        + D(counters["fabric_cached_tokens"]) * 10
        + D(counters["fabric_output_tokens"]) * 400
    ) / 1000
    discovery = D(counters["discovery_reads"]) * 1000
    return {
        "trace_id": trace_id,
        "basis": "illustrative",
        "work_iq_credits": str(credits),
        "fabric_ai_query_cu_s": str(ai_query),
        "fabric_discovery_cu_s": str(discovery),
        "foundry_mode": model_mode,
        "foundry_tokens": {
            "uncached_input": counters["foundry_uncached_tokens"],
            "cached_input": counters["foundry_cached_tokens"],
            "output": counters["foundry_output_tokens"],
        },
        "work_iq_tools_reference_usd": f"{credits * D('0.01'):.4f}",
        "fabric_hypothetical_allocation_usd":
            f"{(ai_query + discovery) / 3600 * D('0.18'):.4f}",
        "complete_workflow_cost_usd": None,
        "unpriced": [
            "Chat/Context", "query engines", "ontology reasoning",
            "OneLake", "Foundry model or PTU", "AI Search", "tools/compute",
        ],
    }


usage = {
    "tools_calls": 20, "fabric_uncached_tokens": 2000,
    "fabric_cached_tokens": 0, "fabric_output_tokens": 500,
    "discovery_reads": 1, "foundry_uncached_tokens": 1500,
    "foundry_cached_tokens": 0, "foundry_output_tokens": 250,
}
print(json.dumps(attribute_partial("sinistro-demo-001", usage, "standard"),
                 indent=2))
Saída do exemplo, conferida por execução local:
{
  "trace_id": "sinistro-demo-001",
  "basis": "illustrative",
  "work_iq_credits": "2.0",
  "fabric_ai_query_cu_s": "400",
  "fabric_discovery_cu_s": "1000",
  "foundry_mode": "standard",
  "foundry_tokens": {"uncached_input": 1500, "cached_input": 0, "output": 250},
  "work_iq_tools_reference_usd": "0.0200",
  "fabric_hypothetical_allocation_usd": "0.0700",
  "complete_workflow_cost_usd": null,
  "unpriced": [
    "Chat/Context", "query engines", "ontology reasoning",
    "OneLake", "Foundry model or PTU", "AI Search", "tools/compute"
  ]
}
O código valida entrada e calcula parcelas; não chama serviços nem reconcilia faturas. unpriced aponta componentes a medir ou precificar, se usados. No provisionado, tokens continuam como utilização, não segunda tarifa. Na aplicação real, preserve tentativas e origem da medição; o trace_id não cria integração automática entre painéis.
Quem responde pelo orçamento e pelo limite?
Defina três responsabilidades: administrador de Microsoft 365 para política de créditos; administrador de capacidade para Fabric; dono do recurso/deployment para Foundry e AI Search. Uma pessoa pode acumular papéis, mas o fluxo precisa de um responsável final.
Use correlação na aplicação, com serviço, operação, tentativas e origem do consumo. Os painéis não necessariamente aceitam o identificador nem entregam custo por tarefa; reconcilie agregados.
No Microsoft 365 admin center, use Copilot > Cost management. No Fabric, acompanhe AI Query, Ontology Discovery e demais operações no Capacity Metrics. No Azure, reconcilie recursos e modalidades de cobrança.
Esses painéis não são um freio instantâneo: a documentação informa refresh de 4 horas na visão Overview de créditos e 2 horas na Consumption. Controle tentativas e orçamento operacional na aplicação; declare falhas em vez de repetir até consumir o limite.
Boas práticas para produção
- Versione o mapa: endpoint, operação, preço, região, plano, data da leitura e dono.
- Separe caches: cache do modelo, entrada cacheada do data agent e definição da ontologia não têm o mesmo efeito financeiro.
- Limite fan-out e retry: múltiplas fontes e tentativas podem ampliar consumo mesmo quando a resposta final é curta.
- Rateie sem duplicar: capacidade integral na fatura e parcela do agente não são dois custos a somar no consolidado.
- Trate franquia e preview como condições: não projete operação sustentada como se toda chamada fosse gratuita.
- Otimize com qualidade: reduzir contexto ou raciocínio só é economia se preservar a resposta necessária ao negócio.
Perguntas frequentes (FAQ)
Ter Microsoft 365 Copilot elimina a cobrança do Work IQ API?
Não para agentes próprios e de terceiros. A página de acesso e preço distingue essas chamadas das experiências cobertas pela licença.
A pergunta custa 0,1 Copilot Credit?
Não necessariamente. Esse é o componente estático por chamada de Tools API, não uma tarifa universal por pergunta ou tarefa.
Se o Fabric já está pago, o agente não custa nada?
Pode não haver aumento imediato da fatura, mas há consumo de capacidade e disputa por folga. Mostre custo atribuído e impacto incremental separadamente.
Foundry IQ e o modelo usam o mesmo medidor?
Não. AI Search mede recuperação; Azure OpenAI mede o LLM quando usado. Agente, conhecimento e modelo podem atravessar recursos e orçamentos diferentes.
Conclusão
A arquitetura decide onde o trabalho acontece; o medidor decide como ele aparece na conta. Antes de escolher o modelo mais barato, identifique as chamadas que ele provocará. Um orçamento confiável preserva as unidades originais, converte com o plano correto, rateia capacidade e nomeia quem responde pelo crescimento.
Referências oficiais
- Work IQ: acesso e preço.
- Copilot Credits Guide — preços e Work IQ.
- Cobrança e gestão de Copilot Credits.
- Monitorar consumo de créditos.
- Consumo do Fabric data agent.
- Cobrança da nova ontologia.
- Preço da capacidade Fabric.
- Foundry Agent Service: cobrança.
- Foundry IQ: requisitos e cobrança.
- Recuperação agêntica: modelo de cobrança.
- Consentimento de cobrança da recuperação.
- Foundry: tokens e throughput provisionado.
👉 Se você está compondo um agente com Microsoft 365, Fabric e Foundry — especialmente em uma capacidade compartilhada, este é o momento de desenhar a conta antes de ampliar o uso. Quer trocar ideia sobre FinOps de agentes? Me chama no LinkedIn.