O incidente que eu mais vejo em pipeline de dados com CI/CD não acontece no deploy. O pull request passou por revisão, os testes rodaram, o bundle deploy ficou verde em staging e depois em produção. Semanas depois, uma mudança incompatível na bronze — a streaming table que lê de um tópico do Kafka com retenção de 24 horas — exige um full refresh, e alguém roda. A tabela é truncada, os checkpoints são apagados e o stream recomeça do início; para o Kafka, o início é ontem. O deploy levou o código certo; o histórico que só existia na tabela não voltou. Na retrospectiva, ninguém discute o YAML. A pergunta é o que mais vive só em produção.
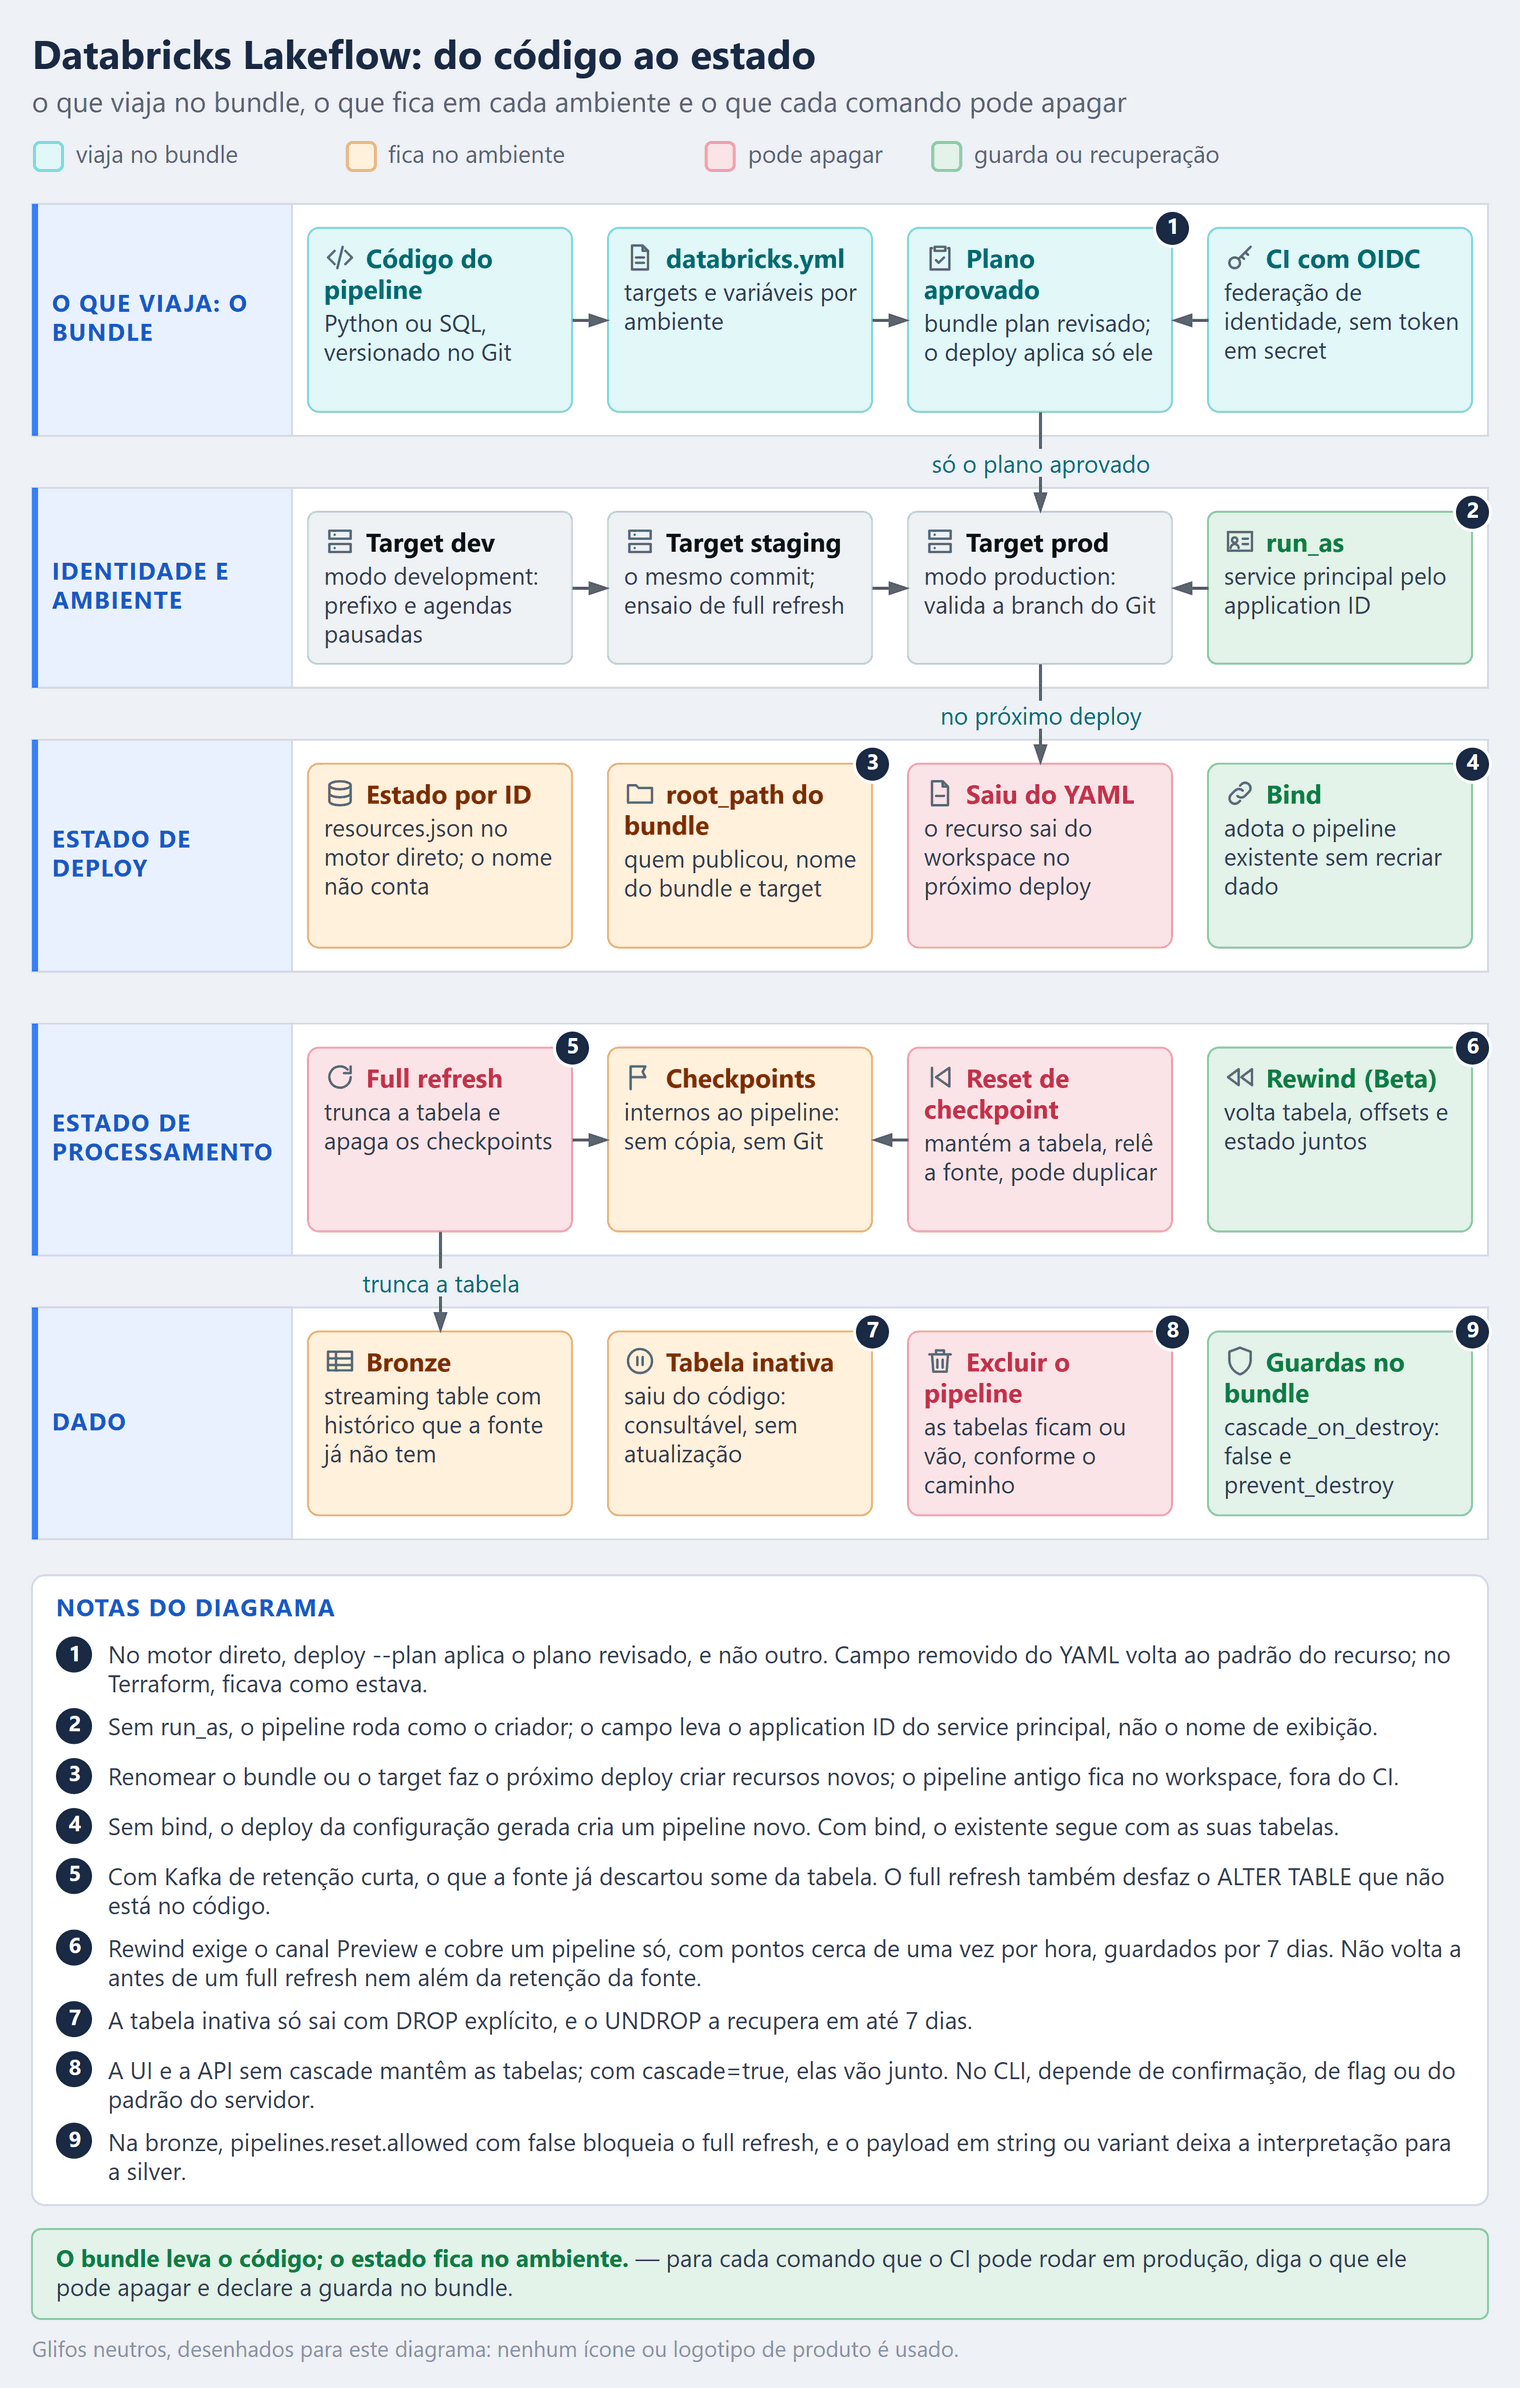
Do código ao estado O Databricks Lakeflow, com os Declarative Automation Bundles — o novo nome dos Databricks Asset Bundles —, resolve bem a metade do CI/CD de dados que se parece com software: o pipeline vira código, o código passa por review e o mesmo commit chega a dev, staging e produção. A outra metade não viaja. O registro do que cada deploy criou, os checkpoints de cada flow, as tabelas e a identidade que roda o pipeline pertencem ao ambiente: o código viaja e o estado fica. A regra cabe numa linha — o bundle leva o código; o estado fica no ambiente — e este artigo é sobre o que ela implica: os quatro estados que o bundle não leva, o que cada comando do CI pode apagar e as guardas que se declaram antes do primeiro deploy em produção.
O que é pipeline como código no Databricks Lakeflow?
O nome mudou duas vezes em pouco tempo, e isso atrapalha até a busca. O produto que se chamava Delta Live Tables agora é Lakeflow pipelines, e a página de migração não deixa dúvida: “there is no migration required to use Lakeflow pipelines: your code will still work”. Os pipelines do Lakeflow estendem e são interoperáveis com o Apache Spark Declarative Pipelines, o framework declarativo aberto do Spark, com compatibilidade a partir do Apache Spark 4.1. No Python, import dlt dá lugar a from pyspark import pipelines as dp; os nomes antigos continuam funcionando, mas a recomendação é passar para os novos. E o DLT não sumiu de todo: os SKUs clássicos na fatura ainda começam com DLT.
O empacotamento também trocou de nome: os Declarative Automation Bundles se chamavam Databricks Asset Bundles. A documentação os define como “an infrastructure-as-code (IaC) approach” e como “a feature of the Databricks CLI”: você descreve jobs, pipelines e demais recursos em YAML, ao lado do código, e o CLI publica tudo no workspace de cada ambiente. A página do pipeline versionado separa bem os papéis: “A bundle is not a separate extract, transform, load (ETL) framework or an alternative to Lakeflow pipelines. It is a packaging and deployment format”. O Lakeflow diz o que o pipeline faz; o bundle diz como ele é entregue.
O esqueleto vem pronto. O databricks pipelines init gera um databricks.yml na raiz, com o nome do bundle e os targets; a definição do pipeline em resources/; um job de exemplo; e as transformações em src/, numa pasta transformations. Cada target — dev, staging, prod — aponta para um workspace, um modo de deploy e os valores que mudam de um ambiente para outro.
O motor de deploy também mudou. Bundles criados a partir do CLI 1.3.0 usam por padrão o motor direto, no lugar do Terraform, e a partir do CLI 1.14.0 os bundles que ainda estão no Terraform “are automatically migrated to the direct engine after a deploy whose dry-run conversion comes back clean”. Dá para recusar com bundle.engine: terraform, mas a recomendação é migrar, porque o motor Terraform “will soon be disabled”. No caminho, o arquivo de estado do deploy troca de formato — de terraform.tfstate para resources.json —, e isso volta a importar adiante.
O problema que resolve
CI/CD de aplicação parte de uma premissa que dado não cumpre: a de que o ambiente pode ser recriado a partir do repositório. Uma API sem estado sobe de novo a partir da imagem; um pipeline de streaming não. A checklist de prontidão para produção do Lakeflow pede o que se espera de engenharia de software — o pipeline “defined and deployed through a bundle, not hand-clicked into existence in the UI” e “at least a dev and a prod target (ideally dev, staging, and prod)” —, e o bundle entrega isso. O que ele não entrega é o que nunca esteve no Git.
São quatro estados, e cada ambiente tem os seus:
- Estado de deploy — o registro, por ID, de quais recursos aquele bundle criou naquele workspace.
- Estado de processamento — os checkpoints de cada flow de streaming, que dizem até onde a fonte já foi lida.
- Dado — as streaming tables e materialized views, com o histórico que a fonte talvez já não tenha.
- Identidade e ambiente — quem roda o pipeline, quais catálogos e permissões existem, qual o canal de runtime e quanto tempo a fonte retém.
Na arquitetura medallion, é a bronze que guarda o histórico bruto que a fonte não guarda mais — e é nela que o problema dói. O que o Git não guarda, o deploy não restaura.
Como funciona — passo a passo
- Comece pelo bundle, não pela UI. O
databricks pipelines initcria o projeto do zero. Para um pipeline que já existe,databricks bundle generate pipelinegera a configuração edatabricks bundle deployment bindamarra o recurso do bundle ao pipeline existente. Sem o bind, o deploy da configuração gerada “creates a new resource rather than updating the existing one”. - Parametrize o que muda por ambiente. Catálogo e endereço do Kafka entram como variáveis do bundle e chegam ao código pela
configurationdo pipeline. A página de conversão para bundle é precisa: “Pipeline parameters apply to SQL source code only.” Em Python, o valor vem daconfiguratione é lido comspark.conf.get(). - Desenvolva no target de dev, em modo development. O modo prefixa os recursos com
[dev <usuário>], marca os pipelines comodevelopment: true, pausa agendas e gatilhos e desliga o lock de deploy. O prefixo separa os recursos de cada desenvolvedor; as tabelas vão para o catálogo e o schema que o target declarar. - Planeje antes de aplicar. O
databricks bundle plan“displays the actions which will be performed on resources that would be deployed, without making any changes”, e com-o jsono plano vira artefato do CI. No motor direto,databricks bundle deploy --plan plan.jsonaplica aquele plano, e não outro: são os “replayable plans”, que garantem “that only approved actions reach production”. - Promova para prod em modo production. O modo production valida que os pipelines estão com
development: falsee, se o target declarar uma branch do Git, que o deploy sai dela. O pipeline roda como service principal, declarado emrun_aspelo application ID. O CI se autentica por federação de identidade (OIDC): no exemplo do GitHub Actions,DATABRICKS_AUTH_TYPE: github-oidce uma política de federação no service principal, sem token de acesso guardado como secret. A página de conversão ainda pede um portão humano: “Gate the production deploy behind a manual approval (for example, a second job that requires a GitHub Environment approval, or a separate stage in Azure DevOps) so a person explicitly approves each promotion.” - Rode produção por job ou pela API. Atualizações “started from Jobs or the Pipelines API” usam retry e restart automáticos. O Run now da UI, em pipelines não contínuos, usa o comportamento de depuração, que “Disables pipeline retries so you can immediately detect and fix errors.” O botão é para desenvolvimento; produção roda pelo agendador.
Os quatro estados que o bundle não leva
Cada estado tem um comando que o altera e uma pergunta que a revisão de produção precisa responder antes do primeiro deploy.
1. Estado de deploy: o bundle só conhece o que criou
O bundle rastreia o que criou por ID, num estado guardado no file system do workspace: “Resource names are not used to correlate between a bundle deployment and a resource instance”. Três consequências vêm daí. A primeira: recurso que sai da configuração sai do workspace — “If a resource is removed from the bundle configuration, it is removed from the target workspace if it was previously deployed.” A segunda: a identidade do deploy é o root_path do bundle, que por padrão é ~/.bundle/${bundle.name}/${bundle.target} e combina quem publicou, o nome do bundle e o target; não confunda com o root_path do recurso de pipeline, que aponta a pasta do código. A terceira: a associação com um recurso “can only be forgotten if you change the bundle name, the bundle target, or the workspace”. Renomear o bundle ou o target faz o próximo deploy criar recursos novos, e o pipeline antigo fica no workspace, fora do controle do CI.
Para trazer um pipeline existente para o bundle, o caminho é o bind, e a página garante o que importa: “Bind does not recreate data” — o pipeline continua com as tabelas, sem recomputar nada. O motor direto muda duas coisas aqui. O estado passa de terraform.tfstate para resources.json, e o motor “only records local configuration in its state file”. E campo removido do YAML muda de sentido: no Terraform, “removing a set field from your databricks.yml leaves the corresponding value unchanged in the platform”; no motor direto, a remoção “reverts the value to the resource’s default”. A regra da página vale para qualquer motor: “To persist a value, set it explicitly in your configuration rather than relying on the previously deployed value.”
2. Estado de processamento: o checkpoint não é seu
Cada flow que escreve numa streaming table tem um checkpoint, e a página de recuperação é direta: “These checkpoint locations are internal to the pipeline and are not accessible to the users.” Você não copia checkpoint de staging para produção, nem guarda checkpoint no Git. O que você controla é quando ele é apagado.
O full refresh “truncates the streaming table, removes all checkpoint data, and restarts the streaming process with new checkpoints for every flow writing to the table.” E ele não é evento raro. A página lista o que o exige: renomear coluna sem column mapping, estreitar tipo (de BIGINT para INT), trocar particionamento legado por clustering, mudar a tabela, o tipo ou o tópico de origem, recriar a tabela Delta de origem, mexer em chaves e funções de agregação, em joins ou na deduplicação — e quando “CDC logs have become unavailable due to retention expiration”. Boa parte das refatorações de bronze e silver cai nessa lista.
| Operação | Tabela | Checkpoint | Com fonte de retenção curta |
|---|---|---|---|
| Full refresh | truncada e reprocessada | apagado | o que a fonte já descartou some da tabela |
| Reset de checkpoint | mantida | apagado nos flows escolhidos | relê a fonte e pode gravar duplicados |
| Rewind (Beta) | volta a uma versão anterior | volta junto, com offsets e estado | falha se a fonte já descartou o dado |
A primeira linha é o incidente da abertura, e a página de atualizações o descreve sem eufemismo: “Records no longer present in the Kafka source are dropped from the target table.” A de full refresh generaliza — “A full refresh does not reprocess data unless your source retains the full historical dataset” — e oferece o reset de checkpoint como alternativa, com um aviso: “this may lead to duplicate data being written to the target table.”
O rewind, em Beta, muda a conversa sobre rollback de dado. Ele “restores table versions, streaming source offsets, and operator state together, so replay does not skip records or write duplicates.” O pipeline gera pontos de rewind “about once an hour” e os guarda por 7 dias. Os limites, porém, são de arquitetura: exige o canal Preview e a configuração pipelines.rewind.betaEnabled; “cannot restore a pipeline to a point before a full refresh”; cobre um pipeline só, sem coordenar outros pipelines nem leitores externos; não restaura código, configuração, tags nem grants do Unity Catalog; e falha se a fonte não guardou o dado — a página dá o exemplo de “a Kafka topic that keeps one day”. Ele também não dispara nada sozinho: “Rewind does not start the pipeline”.
Para mudança de schema, o ALTER TABLE em streaming tables, também em Beta, oferece operações “metadata-only”: sem full refresh, sem reset de checkpoint e sem reingestão. Só que a mudança vive no ambiente, não no código — “A full refresh regenerates the streaming table from the pipeline source code, so column changes made with ALTER TABLE are not preserved.” Se a alteração não for repetida no código, o próximo full refresh a desfaz.
3. Dado: tirar do código não apaga, e excluir depende do caminho
Tirar a definição de uma tabela do pipeline não apaga a tabela. Na página de Unity Catalog, “Tables can become inactive if their definition is removed from a pipeline”, e “You can still query inactive tables, but the pipeline no longer updates them. To clean up materialized views or streaming tables, explicitly DROP the table.” Um DROP por engano tem volta: “You can recover dropped tables within 7 days by using the UNDROP command.” Quem prefere o comportamento antigo liga pipelines.dropInactiveTables com true: a entrada inativa sai do Unity Catalog na atualização seguinte, e o dado só volta, em até 7 dias, se a definição voltar ao pipeline. Trocar o catálogo ou o schema padrão sem nomes totalmente qualificados tem efeito parecido: a tabela nasce no lugar novo, e a antiga fica inativa.
Excluir o pipeline é outra conversa. No modo de publicação padrão — pipelines criados antes de 5 de fevereiro de 2025 podem estar no modo legado —, as tabelas ficam retidas por padrão e podem ser consultadas, mas não atualizadas até irem para um pipeline ativo. O resultado depende do caminho:
| Caminho | O que acontece com as tabelas |
|---|---|
| Excluir pela UI | ficam, por padrão |
API sem cascade |
ficam, por padrão |
API com cascade=true |
são apagadas junto |
databricks pipelines destroy |
o tutorial pede confirmação para apagar as tabelas e views gerenciadas |
bundle destroy sem cascade_on_destroy |
vale o padrão do servidor, que a página não informa |
| Pipeline removido do YAML | o pipeline sai no próximo deploy; a página não diz o que acontece com as tabelas |
Os dois caminhos seguros por padrão, com a regra escrita, são a UI e a API sem cascade. Os caminhos do CLI dependem de confirmação, de flag ou de um padrão que não está na página. Por isso a guarda vai para o bundle: cascade_on_destroy com false, que a referência descreve como a forma de “retain the datasets on destroy”, disponível no motor direto a partir do CLI 1.12.0.
Mover tabela entre pipelines também é operação de estado. Com ALTER STREAMING TABLE … SET TBLPROPERTIES("pipelines.pipelineId"="<id>"), uma streaming table passa para outro pipeline sem full refresh — no Databricks Runtime 16.3 ou superior, e no 17.2 para mover entre workspaces. A página exige que quem roda o comando seja o run-as dos dois pipelines e dono de ambos, que o destino esteja no modo de publicação padrão e que o comando rode no workspace do pipeline de origem.
E vale o que eu escrevi sobre federação ou ingestão: quando você decide ingerir, passa a ser dono de um estado que antes era da fonte. A streaming table da bronze é esse estado.
4. Identidade e ambiente: o mesmo YAML em outro mundo
O run_as existe para “separate the identity used to deploy a bundle job or pipeline from the one used by the job or pipeline workflow to run”. Sem ele, “the pipeline runs as the user who created the pipeline”, e produção passa a depender da conta de uma pessoa. A página de conversão para bundle dá o motivo de trocar: “so runs don’t break when someone leaves the team or changes roles”.
Três detalhes só aparecem no primeiro deploy de produção. Se a identidade que publica for diferente da declarada em run_as, “only jobs and pipelines are supported” no bundle. O service_principal_name recebe o application ID do service principal, e não o nome de exibição. E a página avisa que quem não é admin só pode preencher o run_as com o próprio e-mail.
Fora do YAML, o ambiente carrega o resto: catálogos e grants do Unity Catalog, o service principal e a política de federação do CI, a retenção do tópico no Kafka, o canal de runtime. Staging com sete dias de retenção e produção com um dia fazem o mesmo full refresh terminar de dois jeitos. O mesmo comando tem consequência diferente em cada ambiente, porque o estado é diferente.
Guardas declaradas no bundle
A saída não é proibir o full refresh. É declarar no bundle o que cada ambiente permite, e a regra que eu levo para a revisão cabe numa frase: declare o que o destroy apaga — e, junto, o que o full refresh e o reset podem apagar. Um bundle de pedidos que lê do Kafka, com as guardas no target de produção:
# databricks.yml
bundle:
  name: pedidos

variables:
  catalog:
    description: Catálogo do ambiente
  kafka_servers:
    description: Servidores do Kafka do ambiente

resources:
  pipelines:
    pedidos_pipeline:
      name: pedidos-pipeline
      catalog: ${var.catalog}
      schema: pedidos
      serverless: true
      root_path: src/pedidos_pipeline
      libraries:
        - glob:
            include: src/pedidos_pipeline/transformations/**
      configuration:
        kafka_servers: ${var.kafka_servers}

targets:
  dev:
    mode: development
    default: true
    variables:
      catalog: dev
      kafka_servers: kafka-dev.exemplo.interno:9093

  prod:
    mode: production
    variables:
      catalog: prod
      kafka_servers: kafka-prod.exemplo.interno:9093
    run_as:
      service_principal_name: <application-id>
    resources:
      pipelines:
        pedidos_pipeline:
          cascade_on_destroy: false  # CLI 1.12.0+, motor direto
          lifecycle:
            prevent_destroy: true    # CLI 0.268.0+
from pyspark import pipelines as dp


@dp.table(
    comment="Bronze de pedidos: payload do Kafka como string, interpretado na silver",
    table_properties={"pipelines.reset.allowed": "false"},
)
def pedidos_bronze():
    # opções de autenticação do Kafka omitidas
    return (
        spark.readStream.format("kafka")
        .option("kafka.bootstrap.servers", spark.conf.get("kafka_servers"))
        .option("subscribe", "pedidos")
        .load()
        .selectExpr("CAST(key AS STRING) AS key", "CAST(value AS STRING) AS value", "timestamp")
    )
Duas decisões moram nesses arquivos. A bronze flexível segue a página de full refresh, que, para fontes de retenção curta, manda gravar o dado bruto numa streaming table e “Use flexible column types (variant or string, for example)”: a interpretação fica na silver, e mudar a silver não obriga a refazer a bronze. E pipelines.reset.allowed “Controls whether a full refresh is allowed for this table”: com false, o full refresh deixa de ser permitido para a bronze.
# pipeline que já existe: gere a configuração e faça o bind antes do primeiro deploy
databricks bundle generate pipeline --existing-pipeline-id <pipeline-id>
databricks bundle deployment bind pedidos_pipeline <pipeline-id> --target prod

# rotina de produção: validar, planejar, revisar e aplicar só o plano aprovado
databricks bundle validate --target prod
databricks bundle plan --target prod -o json > plan.json
databricks bundle deploy --target prod --plan plan.json --fail-on-active-runs
Algumas flags merecem atenção na revisão do CI. --fail-on-active-runs faz o deploy “Fail if there are running jobs or pipelines in the deployment.” --force serve para “Force-override Git branch validation” e não tem lugar em produção. --force-lock “should only be used if the previous deployment crashed or was interrupted and left a stale lock file.” E o bundle destroy, que “permanently deletes a bundle’s previously-deployed jobs, pipelines, and artifacts”, esbarra no prevent_destroy: “You can use the lifecycle setting to prevent specific resources from being destroyed.”
Onde a documentação pede leitura atenta
| O que a página diz | Onde | Como ler |
|---|---|---|
| excluir o pipeline mantém as tabelas | Unity Catalog em pipelines | vale para a UI e a API sem cascade; o tutorial de bundles avisa que pipelines destroy apaga tabelas e views gerenciadas |
cascade_on_destroy sem valor usa o padrão do servidor |
recursos dos bundles | a página não diz qual é o padrão, e o campo exige o motor direto; declare false |
| a troca de nome é non-breaking | FAQ dos bundles | vale para o rename dos bundles; o do DLT tem efeitos próprios, como o import novo e os SKUs clássicos ainda com DLT no nome |
storage guarda checkpoints e tabelas |
recursos dos bundles | a referência de propriedades marca o campo como legado; com Unity Catalog, os checkpoints são internos |
| rewind exige o canal Preview | rewind | com rewind ligado, o pipeline só volta ao canal Current quando o Current tiver um runtime com rewind |
ALTER TABLE é metadata-only |
evolução de schema | a mudança não sobrevive a um full refresh se não estiver no código |
exemplo de run_as com deploy em /Shared |
run-as | o FAQ pede deploy de produção como service principal, num caminho do time, fora de /Workspace/Shared |
Nenhuma dessas divergências impede o desenho, mas cada uma vira pergunta na revisão de produção. Anote a página e a data em que você leu: a página de rewind é de 29/09/2026, e a de Unity Catalog em pipelines foi atualizada em 30/09/2026.
Boas práticas para produção
- Declare
cascade_on_destroy: falseeprevent_destroyno target de produção. O padrão do servidor não está escrito; a sua guarda está. - Proteja a bronze. Payload flexível, em string ou variant, e
pipelines.reset.allowedcomfalsenas tabelas cuja fonte não retém histórico. - Não renomeie bundle nem target sem plano de bind. A associação com os recursos se perde, e o pipeline antigo fica órfão.
- Traga pipeline existente com generate e bind. Só o generate cria um recurso novo no deploy.
- Rode produção como service principal, com deploy num caminho do time. Nada de pipeline de produção na conta de uma pessoa, nem de deploy em
/Workspace/Shared. - Aplique só o plano aprovado. O
bundle planvira artefato, uma pessoa aprova, e o deploy de prod usa--plan. - Use nomes totalmente qualificados para a tabela não nascer em outro lugar quando o catálogo ou o schema padrão mudar.
- Ensaie full refresh e recuperação de checkpoint em staging. A página de full refresh pede: “Test the operation in a development or staging environment.”
- Garanta retenção na fonte. “Ensure the source system retains enough historical data to replay the stream.” A retenção do Kafka é decisão de arquitetura, não detalhe de infraestrutura.
- Registre o que não está no Git, por ambiente: retenção das fontes, canal de runtime, grants, service principal e política de federação.
- Rode produção pelo job ou pela API, com retry automático; o Run now da UI é para desenvolvimento.
- Migre para o motor direto relendo os campos removidos. No direto, campo removido volta ao padrão do recurso.
O que precisa estar de pé
A ordem abaixo é causal, não cronológica: cada estágio existe porque o anterior ficou de pé.
Fundação — o código tem um caminho só. O pipeline nasce e muda pelo bundle; dev, staging e prod são targets do mesmo repositório; o CI se autentica por OIDC e aplica só planos aprovados; produção roda como service principal.
Está de pé quando ninguém muda o pipeline de produção sem commit, e cada deploy de prod aponta para um commit e um plano aprovado.
Produção com contexto — o estado tem dono. Cada streaming table de produção tem fonte e retenção documentadas; cascade_on_destroy, prevent_destroy e pipelines.reset.allowed estão declarados onde importam; o full refresh e a recuperação de checkpoint foram ensaiados em staging.
Está de pé quando, para cada streaming table de produção, alguém responde em um minuto de onde ela volta e quanto histórico se perde.
Escala e eficiência — as guardas nascem no template. O template do time já traz as guardas, o service principal e o caminho de deploy; o motor direto é o padrão; o rewind entra no runbook quando sair do Beta.
Está de pé quando um pipeline novo chega a produção com as guardas declaradas sem ninguém lembrar delas no review.
Pular estágio não acelera nada: sem o caminho único do código, o estado muda por fora do CI; sem dono para o estado, escalar é multiplicar tabelas que ninguém sabe repor.
Perguntas frequentes (FAQ)
O Lakeflow é um produto novo que exige migração?
Não. É o novo nome do Delta Live Tables, e a página é direta: “there is no migration required”. O código continua funcionando; os nomes antigos da API Python seguem aceitos, mas a documentação recomenda os novos, como from pyspark import pipelines as dp.
Preciso sair do Terraform?
Bundles novos já nascem no motor direto desde o CLI 1.3.0, e a partir do 1.14.0 os bundles em Terraform migram sozinhos depois de um deploy com conversão limpa. Dá para ficar com bundle.engine: terraform, mas a página avisa que ele “will soon be disabled”. Planeje a migração e releia os campos que você removeu do YAML.
O bundle leva os checkpoints?
Não. Os checkpoints são internos ao pipeline e ficam no ambiente. O deploy também não dispara full refresh: “Full refreshes must be triggered explicitly.” O risco está em quem roda o comando — e com qual flag.
Excluir o pipeline apaga as tabelas?
Depende do caminho. Pela UI, não, por padrão. Pela API, só com cascade=true. Pelo bundle destroy, depende de cascade_on_destroy — e, sem valor declarado, vale um padrão que a página não informa. Declare false em produção.
Existe rollback?
Para o código, sim: reverta o commit e publique de novo. Para o dado, o rewind, em Beta, volta tabelas, offsets e estado juntos, até 7 dias, mas não antes de um full refresh e não além da retenção da fonte. Os dois rollbacks são independentes: o rewind não restaura código, e o deploy não restaura dado.
Dá para mover uma tabela de pipeline sem full refresh?
Sim, com pipelines.pipelineId no ALTER STREAMING TABLE, no Databricks Runtime 16.3 ou superior. É uma operação de estado, feita no ambiente e fora do bundle, e exige a mesma identidade como run-as e dona dos dois pipelines.
Conclusão
O Databricks Lakeflow com bundles resolveu a metade do CI/CD de dados que se parece com software: o pipeline é código, passa por review e chega igual a todo ambiente. A outra metade é estado, e ela não viaja. O registro do deploy, os checkpoints, as tabelas e a identidade são de cada ambiente, e um comando certo no ambiente errado apaga o que o Git nunca guardou.
A saída não é ter medo do full refresh. É tornar cada perda possível explícita no próprio bundle, antes que ela aconteça: para cada comando que o CI pode executar em produção, diga o que ele pode apagar — e declare a guarda no bundle antes do primeiro deploy.
Referências oficiais
- Declarative Automation Bundles — visão geral
- Comandos de bundle do Databricks CLI
- Motor de deploy direto
- Modos de deploy dos bundles
- Recursos dos bundles
- Configuração de bundles
- Identidade de execução (run_as)
- FAQ dos bundles
- Tutorial: pipeline com bundles
- CI/CD com GitHub Actions
- Lakeflow pipelines — visão geral
- O que aconteceu com o Delta Live Tables
- Pipeline versionado em repositório
- Converter um pipeline para bundle
- Checklist de prontidão para produção
- Executar uma atualização de pipeline
- Full refresh de streaming tables
- Recuperar pipeline de falha de checkpoint
- Rewind e replay de pipeline
- Evolução de schema de streaming tables
- Unity Catalog em pipelines
- Mover tabelas entre pipelines
- Propriedades de pipelines
👉 Se você está levando pipelines do Lakeflow para produção — especialmente em banco ou seguradora, onde a bronze costuma ser evidência de auditoria —, declare as guardas antes do primeiro deploy: cascade_on_destroy: false, prevent_destroy, pipelines.reset.allowed na bronze e um service principal no run_as.
Quer trocar ideia sobre CI/CD de dados, bundles e estado no Lakeflow? Me chama no LinkedIn.