A demonstração é sempre a mesma e sempre funciona. Alguém aponta o agente para um lakehouse, pergunta “qual foi a receita do trimestre por região” em inglês, e a resposta vem formatada, com a tabela certa, em quatro segundos. A sala aprova. Três semanas depois, o piloto está com sete fontes que precisavam entrar e só cinco couberam, um diretor perguntando por que o relatório vem cortado em vinte e cinco linhas, e um analista em São Paulo descobrindo que a pergunta em português devolve resultado pior que a mesma pergunta em inglês. Nada disso é defeito. Está tudo documentado — só não estava no slide.
A letra miúda Um agente de dados não é um campo de busca com esteroides. Ele é um componente com contrato de entrada: um conjunto de condições que precisam ser verdadeiras antes de ele responder qualquer coisa, e que não são negociáveis por prompt, por instrução ou por insistência. Conhecer esse contrato é a diferença entre desenhar uma solução que cabe no produto e descobrir o limite quando o piloto já virou compromisso com a área de negócio.
O que é o contrato de entrada do Fabric data agent?
O Fabric data agent é um artefato do Microsoft Fabric, em disponibilidade geral, que transforma pergunta em linguagem natural em consulta sobre os seus dados. Ele não é um copilot: copilot vem pré-configurado e ajuda a escrever código dentro do produto; o data agent é um item que você configura, publica e compartilha, e que outros sistemas podem invocar de fora.
O contrato de entrada é o que ele exige do ambiente antes de existir, e o que ele devolve depois. São quatro blocos:
- Superfície de dado — quais fontes ele aceita, quantas, e em que granularidade você escolhe o que ele enxerga.
- Formato de saída — quanto ele devolve por resposta, em que idioma, e em que modo de operação.
- Identidade e permissão — sob qual identidade a consulta roda, e qual permissão mínima cada fonte exige.
- Fronteira — o que sai da região da sua capacidade, e o que a governança consegue barrar.
Este artigo é a continuação direta de o índice vetorial não herda a permissão da tabela, onde o Fabric data agent apareceu como rota de governança na escolha entre RAG e text-to-SQL. Lá a pergunta era qual rota tem o modelo de permissão certo. Aqui é a pergunta anterior: o que precisa ser verdade para essa rota sequer funcionar.
O problema que resolve
O problema é de sequência. Praticamente todo desenho de agente de dados que eu vejo em campo começa pela pergunta errada — que perguntas o agente vai responder? — quando a pergunta que ordena o projeto é o que ele aceita receber e o que ele consegue devolver?.
Inverter isso produz três tipos de retrabalho que custam caro e são previsíveis:
- A arquitetura desenha oito fontes. O produto aceita cinco. Alguém vai ter que consolidar, e consolidação de fonte é projeto de engenharia de dados, não ajuste de configuração.
- O caso de uso é relatório operacional. A resposta é limitada a vinte e cinco linhas e vinte e cinco colunas. O agente foi desenhado para conversa, não para extração — e extração era exatamente o que a área pediu.
- O público é brasileiro. O suporte documentado é a inglês. Isso não impede a pergunta em português, mas muda o que você pode prometer sobre qualidade, e precisa estar escrito no desenho.
Nenhum desses três é surpresa técnica. Todos os três são leitura de documentação feita depois em vez de antes.
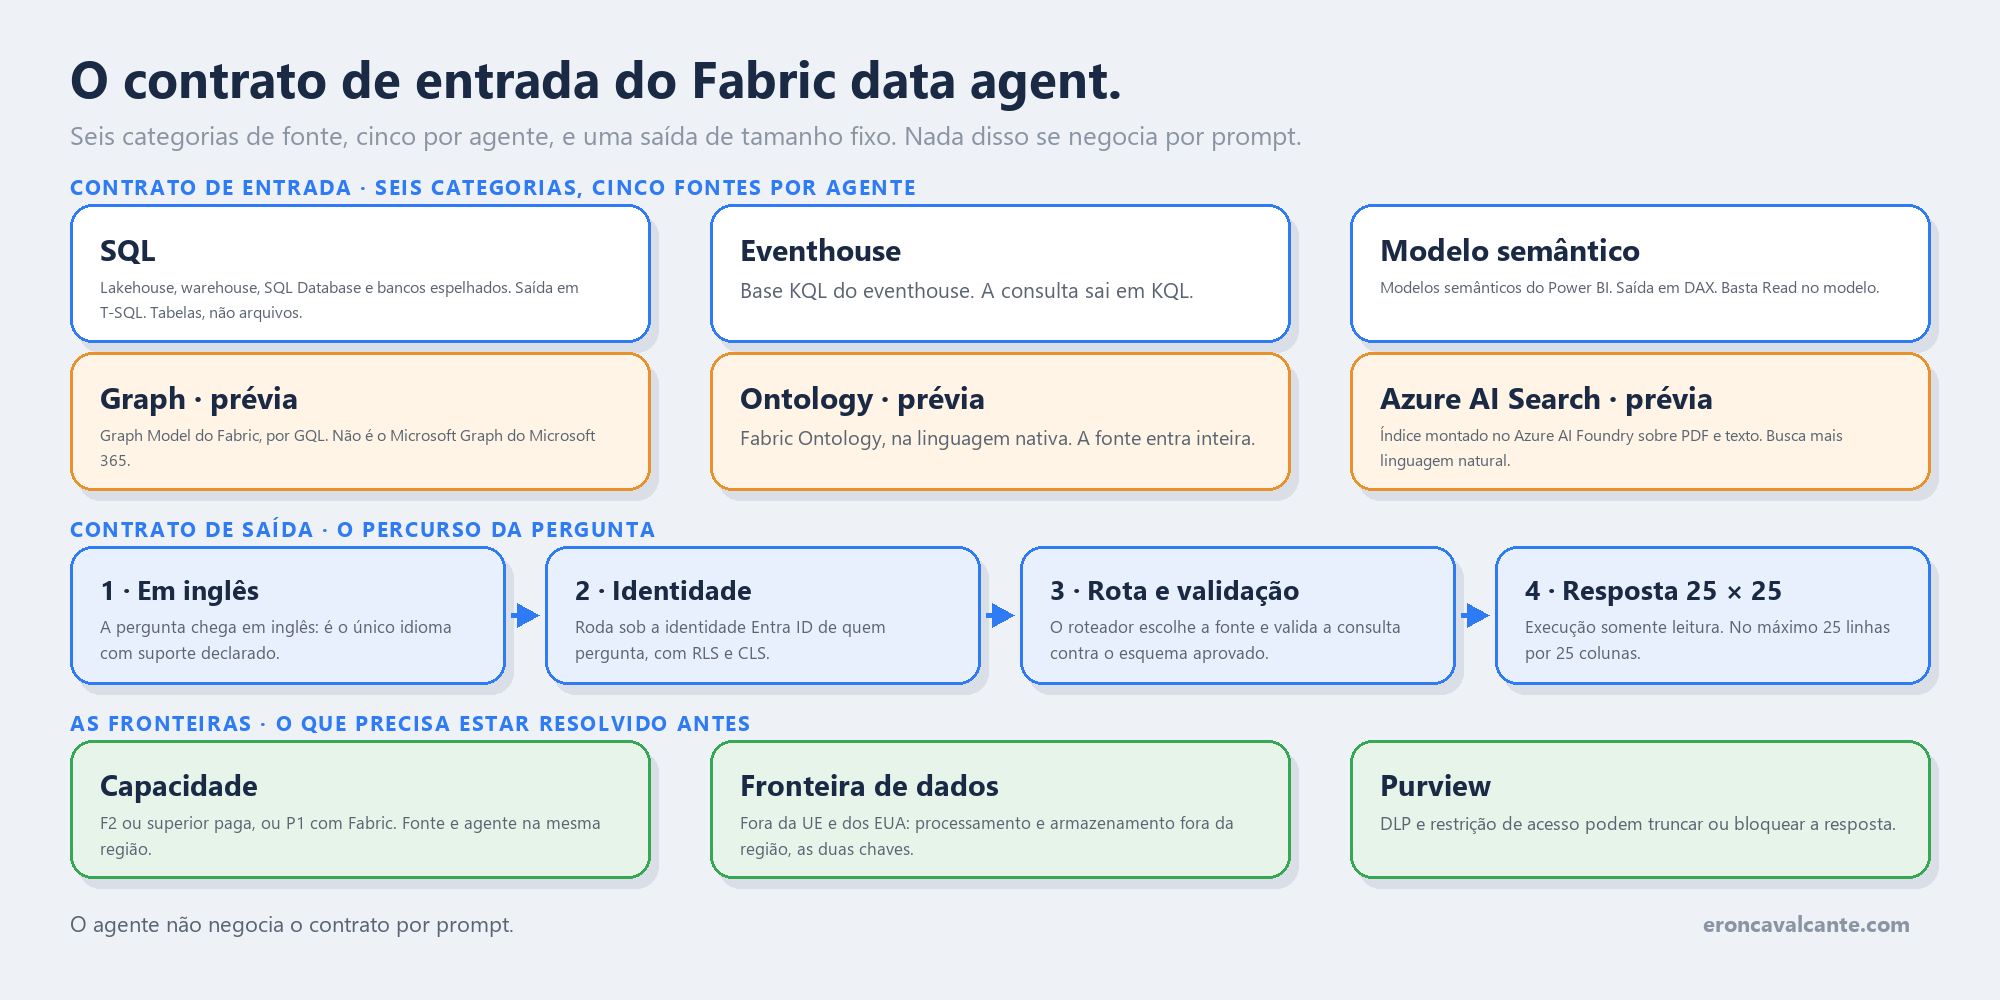
Como funciona — passo a passo
- Confirme a capacidade. É preciso uma capacidade Fabric F2 ou superior paga, ou uma Power BI Premium P1 ou superior com o Fabric habilitado. Não existe data agent em capacidade improvisada.
- Ligue as chaves de tenant. A chave Copilot e Azure OpenAI é obrigatória. Se a região da sua capacidade está fora da fronteira de dados da União Europeia e fora dos Estados Unidos — o caso do Brasil — também são obrigatórias as chaves de processamento e de armazenamento fora da região geográfica. As duas, não uma.
- Escolha as fontes. Até cinco, em qualquer combinação entre as seis categorias. Cinco modelos semânticos é válido; dois modelos, um lakehouse e uma base KQL também.
- Selecione o esquema dentro de cada fonte. Em fonte SQL você escolhe tabelas, exibições e funções. No lakehouse são tabelas, não arquivos: CSV ou JSON precisa ser ingerido antes. Em grafo e em ontologia não há seleção de esquema — entra a fonte inteira.
- Dê contexto. Instruções do agente para roteamento, instruções por fonte para geração de consulta, e até 100 consultas de exemplo por fonte. Modelo semântico é a exceção: exemplos não são suportados ali, e a configuração acontece do lado do Power BI, no Prep for AI.
- Escolha o runtime. O standard é o GA e o padrão para produção. O preview traz mudanças de orquestração e roteamento antes do GA — e é o único que habilita configurações como topics e descrições de objeto de esquema. O runtime não muda quais fontes você pode adicionar, e a atualização do modelo acontece nos dois igualmente.
- Publique. A publicação gera uma versão somente leitura, que é a que os outros consomem; você continua editando o rascunho sem afetar quem já está usando. A descrição que você escrever na publicação vira a descrição da ferramenta anunciada por MCP.
- Compartilhe o agente e o dado. Compartilhar o agente não basta: quem pergunta precisa de permissão na fonte, porque a consulta roda com a identidade dele.
- Avalie antes de chamar de pronto. O SDK de avaliação, em versão prévia, roda um conjunto de perguntas com resposta esperada e grava duas tabelas — o resumo e o passo a passo.
As seis categorias, e por que cinco é o número que importa
A lista de fontes é o ponto onde a documentação mais confunde, e vale ir na página certa. A página por recurso é a autoritativa e a mais atualizada:
| Categoria | Artefato | Linguagem gerada |
|---|---|---|
| SQL | Lakehouse, Data Warehouse, SQL Database, Mirrored Databases | T-SQL |
| Eventhouse | Base KQL do eventhouse | KQL |
| Modelo semântico | Modelos semânticos do Power BI | DAX |
| Grafo (versão prévia) | Graph Model | GQL |
| Ontologia (versão prévia) | Fabric Ontology | nativa da ontologia |
| Azure AI Search (versão prévia) | Índice do Azure AI Search | linguagem natural + busca |
Três leituras que mudam desenho:
Primeira: “SQL” é uma categoria, não uma fonte. Lakehouse, warehouse, SQL Database e bancos espelhados — Azure SQL, Cosmos DB, Snowflake — entram todos pela mesma porta T-SQL, via SQL Analytics Endpoint. Isso amplia o que cabe dentro do limite de cinco muito mais do que a leitura ingênua sugere.
Segunda: o não estruturado entra. O índice do Azure AI Search é fonte suportada, em versão prévia, descrita como índice construído no Azure AI Foundry sobre PDFs, arquivos de texto e outros documentos enriquecidos. Você configura o tipo de busca, o número de documentos recuperados por consulta — a recomendação é de 3 a 20 — e a descrição que ajuda o roteamento. A citação é automática quando o índice tem campo de URL ou de caminho. Vale registrar: eu publiquei o contrário aqui em 1º de setembro, por ter lido uma renomeação de entrada de sumário como remoção de recurso. O artigo foi corrigido nos dois idiomas antes deste sair.
Terceira: não é o Microsoft Graph. A categoria de grafo é o Graph Model do Graph in Microsoft Fabric, consultado por GQL — grafo de propriedades rotulado dentro do Fabric. Não é a API do Microsoft Graph do Microsoft 365. A confusão tem origem documentada: a página de conceitos usa o nome solto “Microsoft Graph”, e a página de compartilhamento chama de “Microsoft Graph in Fabric”. Se o seu desenho previa perguntar sobre e-mail e calendário, o produto é outro.
E o cinco não é um limite de licença que se compra para cima. É o teto do artefato. Precisou de oito fontes, as opções são consolidar antes, dividir em dois agentes e orquestrar por fora, ou rever o recorte do caso de uso.
Vinte e cinco linhas por vinte e cinco colunas
Este é o limite que mais derruba projeto, porque ele não aparece em demonstração — aparece quando alguém tenta usar o agente para o que ele não é.
A documentação é literal: as respostas são limitadas a um máximo de 25 linhas e 25 colunas, porque o agente foi projetado para insight conversacional, não para devolver conjunto de dados completo. E tem um efeito de segunda ordem que quase ninguém antecipa: o histórico da conversa contamina a pergunta seguinte. Se você pediu “mostre todas as linhas deste ano” e recebeu vinte e cinco, a pergunta seguinte pode ser respondida sobre esse recorte já truncado, e não sobre o dado inteiro. A recomendação oficial para esse caso é abrir uma conversa nova.
Some a isso o resto do contrato de saída:
| Limite | Valor | O que ele impede |
|---|---|---|
| Fontes por agente | 5 | Desenho com muitas origens sem consolidação |
| Linhas × colunas por resposta | 25 × 25 | Extração, relatório operacional, exportação |
| Idioma | inglês | Promessa de qualidade equivalente em português |
| Tipo de consulta | somente leitura | Agente que escreve, dispara notebook ou job |
| Consultas de exemplo por fonte | 100 | Ensinar o agente por volume de exemplos |
| Escolha do modelo | não configurável | Trocar o LLM por um seu |
| Região | mesma da capacidade da fonte | Fonte em uma região e agente em outra |
A última linha merece destaque porque falha de forma silenciosa no papel e barulhenta em produção: o agente não executa consulta quando a capacidade do workspace da fonte está em região diferente da capacidade do workspace do agente. Lakehouse em uma região e agente em outra não é questão de latência. É uma consulta que não roda.
Somente leitura, aliás, é estrutural e não uma configuração que se relaxa: ele gera apenas consultas de leitura em SQL, DAX e KQL, e não dispara detecção de anomalia, notebook ou qualquer fluxo de escrita — mesmo onde o eventhouse tem essas integrações disponíveis.
Só em inglês, e o que isso significa na prática
A frase documentada é que o agente não suporta idiomas além do inglês no momento, e que para desempenho ótimo perguntas, instruções e consultas de exemplo devem ser em inglês.
Isso não é um bloqueio de idioma na interface. É uma declaração de escopo de qualidade, e ela tem consequência prática em três lugares que ficam sob seu controle:
- As instruções do agente e as instruções por fonte são escritas por você. Escreva em inglês.
- As consultas de exemplo são suas. Em inglês.
- As descrições de tabela e coluna — inclusive as que vêm do Prep for AI no modelo semântico — alimentam a geração de consulta. Em inglês.
O que sobra em português é a pergunta do usuário final, e é justamente a parte que você não controla. Em um banco ou uma seguradora no Brasil, isso vira requisito de comunicação: o agente responde, mas o desenho não promete paridade. Já vi esse ponto virar crise de confiança por não ter sido dito na primeira reunião.
A identidade é de quem pergunta, e a permissão também
Aqui o produto acerta, e vale entender o mecanismo porque ele é o principal argumento de governança a favor dessa rota.
Não existe chave de Azure OpenAI para gerenciar: o Fabric usa um Assistant do Azure OpenAI gerenciado pela Microsoft e cuida da autenticação. O acesso ao dado, esse sim, roda sob a identidade Microsoft Entra ID de quem faz a pergunta, com as permissões dela. O agente lê esquema e executa consulta apenas onde o usuário tem acesso, e honra RLS e CLS.
A permissão mínima por fonte está documentada, e o detalhe do modelo semântico costuma surpreender:
| Fonte | Permissão mínima para consultar via agente |
|---|---|
| Modelo semântico do Power BI | Read no modelo — sem papel de workspace, sem Build |
| Lakehouse | Read no item, mais acesso à tabela quando houver |
| Warehouse | Read, com SELECT nas tabelas relevantes |
| Base KQL | Papel Reader na base |
| Ontologia | Read na ontologia e na fonte vinculada a ela |
| Graph in Fabric | Read no item de grafo e no dado subjacente |
Abaixo disso, a consulta falha ou devolve vazio — e devolver vazio é o comportamento perigoso, porque parece resposta.
Acima de tudo isso existe uma ordem de precedência que o produto declara: intenção organizacional (políticas de tenant), depois intenção de papel (governança de workspace), depois intenção do desenvolvedor (suas instruções e exemplos), e por último intenção do usuário (a pergunta). Quando há conflito, a camada de cima vence. Instrução que tenta contornar o modo somente leitura ou alcançar fonte fora do escopo é recusada ou redirecionada — não é promessa de comportamento, é precedência declarada.
E há a camada do Purview: DLP no Data Warehouse está em disponibilidade geral, e políticas de restrição de acesso estão em versão prévia para base KQL, SQL Database e warehouse. O efeito prático é que a resposta pode vir truncada ou bloqueada por política, e o usuário verá uma resposta incompleta sem saber por quê. Isso precisa estar na comunicação do agente, não só no desenho.
O percurso completo, do jeito que eu desenho em quadro branco:
pergunta (em inglês)
     │
     ├─ identidade do usuário no Entra ID  ── não é identidade do agente
     │
     ├─ precedência: organização > papel > desenvolvedor > usuário
     │
     ├─ roteamento entre as fontes adicionadas (máx. 5)
     │      ├─ SQL          → NL2SQL   → T-SQL
     │      ├─ eventhouse   → NL2KQL   → KQL
     │      ├─ modelo sem.  → NL2DAX   → DAX
     │      ├─ Graph Model  → NL2GQL   → GQL
     │      ├─ ontologia    → nativa da ontologia
     │      └─ AI Search    → busca no índice do Foundry
     │
     ├─ validação: a consulta só toca o esquema aprovado
     │
     ├─ execução somente leitura, com RLS e CLS do usuário
     │
     └─ resposta: máx. 25 linhas × 25 colunas
            └─ DLP e restrição de acesso do Purview podem truncar
Duas aposentadorias que já venceram
Se você desenhou integração antes de agosto, confira o calendário: 26 de agosto de 2026 foi a data de duas aposentadorias que afetam esse agente.
A primeira é a Assistants API do Azure OpenAI, descontinuada nessa data, com migração para o serviço de agentes do Microsoft Foundry. A segunda é consequência da primeira: a integração do Fabric data agent com o Copilot no Power BI foi aposentada no mesmo dia, porque era essa a camada de orquestração que a sustentava.
O agente em si não foi aposentado. O que mudou foi por onde ele é consumido. Os caminhos que seguem de pé: a experiência nativa do Fabric, o Microsoft Foundry, o Copilot Studio, o Microsoft 365 Copilot e o endpoint MCP — que é o que interessa para quem constrói.
Publicar o agente o transforma em servidor MCP que expõe uma única ferramenta: o próprio agente. O endpoint é previsível:
https://api.fabric.microsoft.com/v1/mcp/workspaces/{WorkspaceId}/dataagents/{DataAgentId}/agent
Três pegadinhas nessa superfície. Primeira: a URL só funciona depois de publicar — montá-la à mão num agente em rascunho devolve erro mesmo estando correta. Segunda: não é REST comum. O cliente precisa cumprir o fluxo MCP — initialize, tools/list, tools/call — e o servidor não suporta registro dinâmico de cliente nem metadados de identidade de cliente, então o cliente tem que obter o token do Fabric pelo próprio fluxo e anexá-lo em cada requisição. Terceira, e é a que o time de risco vai querer por escrito: consumido por MCP, a resposta pode sair da fronteira de conformidade e da região geográfica do Fabric, passando a valer os termos do cliente MCP que você usou. A mesma ressalva vale para Foundry, Copilot Studio e Microsoft 365 Copilot.
Quando a documentação se contradiz
Vale registrar o método, porque este tema tem armadilha. Duas páginas da mesma documentação discordam hoje:
- A página por recurso lista Azure AI Search como fonte e chama a categoria de grafo de
Graph Model / GQL. - A página de conceitos, mais antiga, ainda escreve “Microsoft Graph” no fluxo e ainda lista, nas limitações, que o agente não suporta dados não estruturados como .pdf, .docx ou .txt.
As duas afirmações da página de conceitos são resíduo. A regra que eu adotei e recomendo: em conflito, prevalece a página por recurso, que é a que o time de produto atualiza a cada mudança de superfície. E há um sinal objetivo para decidir — a data de revisão no rodapé. A de conceitos é de maio; a por recurso é de fim de agosto, revisada em setembro.
Curiosamente, a própria lista de pré-requisitos das páginas de criação, compartilhamento e avaliação ainda enumera warehouse, lakehouse, modelo semântico, base KQL, banco espelhado ou ontologia — sem o índice do Azure AI Search. É a mesma defasagem, no mesmo lugar: o texto de apoio acompanha a superfície com atraso.
Boas práticas para produção
- Leia o contrato antes de desenhar o caso de uso. Cinco fontes, 25 × 25, inglês e somente leitura são premissas de arquitetura, não detalhes de implementação.
- Trate o limite de cinco como orçamento. Agrupe pela categoria SQL sempre que puder: quatro bancos diferentes que já estão espelhados no Fabric consomem menos orçamento do que parecem.
- Não prometa extração. Se a área precisa de lista completa, o entregável é relatório, exportação ou pipeline — e o agente entra para explicar o número, não para produzir a planilha.
- Escreva toda a configuração em inglês e registre no documento de arquitetura que a pergunta em português é suportada sem paridade declarada.
- Fixe o runtime standard em produção e use o preview em um agente espelho, para avaliar mudança de orquestração antes que ela chegue ao GA.
- Publique com descrição escrita para máquina. Ela é lida por orquestrador e por cliente MCP para decidir quando chamar o agente. Descrição vaga vira roteamento errado.
- Verifique região antes de adicionar fonte. Capacidade da fonte e capacidade do agente em regiões diferentes não executa.
- Compartilhe agente e dado juntos. Quem recebe o link sem permissão na fonte recebe resposta vazia, não erro de acesso.
- Avalie com conjunto próprio e olhe a tabela de passos. O resumo diz se acertou; a tabela
_stepsdiz por onde ele foi. Elas respondem perguntas diferentes.
O esqueleto da avaliação cabe em poucas linhas, e é a menor barreira de entrada para deixar de opinar sobre qualidade:
from fabric.dataagent.evaluation import evaluate_data_agent

# Duas tabelas saem daqui: <table_name> com o resumo,
# <table_name>_steps com o raciocínio passo a passo.
evaluation_id = evaluate_data_agent(
    df,                              # colunas: question, expected_answer
    "AgentEvaluation",
    table_name="demo_evaluation_output",
    data_agent_stage="production",   # ou "sandbox"
)
O que precisa estar de pé
A ordem abaixo é causal, não cronológica. Cada estágio depende de o anterior ser verdade, e nenhum deles tem prazo.
Fundação — autoridade sobre o dado. A capacidade é F2 ou superior paga, as chaves de tenant estão ligadas com a decisão de processamento e armazenamento fora da região tomada por escrito, as fontes que o agente vai enxergar estão na mesma região da capacidade dele, e a permissão de cada consumidor na fonte foi conferida — não a permissão no agente, a permissão no dado.
Está de pé quando um usuário sem acesso à tabela recebe vazio por desenho, e alguém consegue explicar por quê sem abrir chamado.
Produção com contexto — semântica virando decisão. As instruções, as descrições de esquema e as consultas de exemplo existem, estão em inglês e foram escritas por quem conhece o negócio. O modelo semântico passou pelo Prep for AI. O agente está publicado, com descrição que um orquestrador consegue ler, e o rascunho evolui separado da versão publicada.
Está de pé quando a mesma pergunta, feita por duas pessoas de áreas diferentes, é roteada para a fonte certa sem instrução adicional.
Escala e eficiência — a plataforma como produto. Existe conjunto de avaliação versionado, a tabela de passos é consultada quando alguém reclama, o runtime de produção é o standard com um espelho em preview, e o consumo por MCP passou pela análise de fronteira de dado antes de existir em produção.
Está de pé quando uma mudança de orquestração do produto é detectada pela sua avaliação antes de ser detectada pelo usuário.
Perguntas frequentes (FAQ)
Dá para aumentar o limite de 25 linhas?
Não por configuração. O limite é do produto e existe para manter a resposta conversacional. Quando a necessidade é conjunto completo, o caminho é a consulta direta na fonte, um relatório ou um pipeline — com o agente explicando o resultado, não produzindo o arquivo.
O Fabric data agent lê PDF?
Não diretamente. Ele não abre .pdf, .docx ou .txt. O caminho documentado é indexar esse conteúdo no Azure AI Search, com o índice construído no Azure AI Foundry, e adicionar o índice como fonte. A diferença importa: o que entra é o índice, e a permissão que vale ali é a do índice.
Então posso mesmo perguntar em português?
Pode, e costuma vir resposta. O que a documentação declara é que idiomas além do inglês não são suportados e que o desempenho ótimo é em inglês. Em desenho corporativo, isso significa: não prometa paridade de qualidade, e mantenha toda a configuração em inglês.
Preciso de permissão de workspace para usar um modelo semântico?
Não. Para interagir com modelo semântico por meio do agente basta Read no modelo. Papel de workspace e permissão Build não são exigidos para essa via — Build continua necessário para modificar o modelo ou usar o Prep for AI. E RLS e CLS continuam valendo.
O agente pode escrever no dado?
Não. Ele gera apenas consultas de leitura e não dispara notebook, job ou detecção de anomalia. Se o seu caso exige ação, o agente de dados é a etapa de consulta dentro de um fluxo maior — a ação pertence a outro componente.
Qual a diferença entre o runtime standard e o preview?
O standard é o GA e muda pouco; o preview recebe mudanças de orquestração, roteamento e geração de consulta antes do GA, e é o único onde vivem configurações como topics e descrições de objeto de esquema. O runtime não altera quais fontes você pode adicionar, e a atualização do modelo de linguagem acontece nos dois.
O que exatamente foi aposentado em 26 de agosto de 2026?
A Assistants API do Azure OpenAI e, por consequência, a integração do Fabric data agent com o Copilot no Power BI. O agente continua disponível pela experiência do Fabric, pelo Foundry, pelo Copilot Studio, pelo Microsoft 365 Copilot e pelo endpoint MCP.
Conclusão
Agente de dados não se avalia pela resposta que ele dá na demonstração. Avalia-se pelo que ele aceita receber e pelo que ele consegue devolver — e essas duas listas são curtas, públicas e não negociáveis por prompt.
Cinco fontes, vinte e cinco linhas por vinte e cinco colunas, inglês, somente leitura, mesma região, identidade de quem pergunta. Quem lê essa lista antes desenha uma solução que cabe. Quem lê depois descobre o contrato quando ele já virou compromisso — e aí a conversa deixa de ser técnica.
No artigo anterior a conclusão foi que o índice não herda a permissão da tabela. Esta é a etapa anterior da mesma ideia: antes de discutir o que o agente herda, confira o que ele aceita.
Referências oficiais
- Adicionar fonte de dado ao data agent
- Conceitos do Fabric data agent
- Criar um Fabric data agent
- Compartilhamento e permissões do data agent
- Configurações de tenant do data agent
- Runtime do Fabric data agent
- Data agent como servidor MCP
- Avaliar o data agent
- Conectar um índice do Azure AI Search
- Adicionar um modelo semântico do Power BI
- Migrar para o serviço de agentes do Foundry
👉 Se você está desenhando um agente de dados sobre Fabric — especialmente em banco ou seguradora, com público que pergunta em português, leia o contrato de entrada antes de fechar o escopo.
Quer trocar ideia sobre agentes de dados, limites de produto e governança no Fabric? Me chama no LinkedIn.