O pedido era o mais inofensivo que existe: resuma os chamados abertos desta semana. Quem pediu foi um analista de operações, com a conta dele, dentro do horário, num agente aprovado pela segurança. O agente fez exatamente o que foi pedido — leu os chamados. E num deles, no meio de um texto de reclamação legítima, havia um parágrafo que não era para o analista ler: era para o agente. Ninguém digitou um prompt malicioso. O prompt do usuário estava limpo. A instrução hostil entrou pela porta que ninguém estava vigiando, que é a porta por onde o conteúdo volta.
A porta de serviço A revisão de segurança de praticamente todo projeto de IA que eu vejo em campo mira o mesmo ponto: o que o usuário digita. Filtro de entrada, classificador de jailbreak, lista de termos proibidos, teste com o time vermelho escrevendo prompts criativos. Tudo isso é necessário e nenhum desses controles olha para onde o ataque caro realmente acontece — o conteúdo que a ferramenta traz de volta para dentro da janela de contexto, sem que ninguém tenha digitado uma linha.
O que é injeção indireta de prompt?
É quando o texto que manipula o modelo não vem de quem está conversando com ele, mas de um conteúdo que o próprio agente foi buscar. O Microsoft Security Response Center define a diferença em uma frase: “Unlike direct prompt injection, where the attacker is the user of the LLM, indirect prompt injection involves the attacker injecting instructions into the interaction between a victim user and the LLM.” Na injeção direta, o atacante é o usuário. Na indireta, o atacante é um terceiro que escreveu antes, em outro lugar, esperando que um agente passasse por ali.
A edição 2026 do OWASP Top 10 para aplicações de LLM trata isso como subtipo nomeado e lista as superfícies de entrega com uma precisão que vale citar: “The model ingests content from an external source (a web page, a document, an email, a tool response, a retrieved RAG passage, an image, an MCP server’s output, a database row, or an issue title) that contains data which acts as prompt injection. The user did not supply or see those instructions.”
Repare no que está nessa lista: a resposta de uma ferramenta e a saída de um servidor MCP. Não é mais só “sites e arquivos”, como na edição anterior. São os canais de retorno do seu próprio desenho de agente.
A causa raiz é arquitetural, e o OWASP a enuncia sem rodeio: “LLMs make no architectural distinction between ‘instructions’ and ‘data’ (both are tokens on the same stream), so there is no clean equivalent to parameterized queries.” É a frase mais importante deste artigo. Em banco de dados nós resolvemos injeção de SQL com prepared statement: o comando viaja por um canal e o dado por outro, e o motor nunca confunde os dois. Em LLM esse canal separado não existe. Instrução e dado chegam como token na mesma sequência, e a separação entre eles é de intenção, não de protocolo.
O problema que resolve
O problema é de posicionamento do perímetro. O OWASP resume o efeito em nove palavras: “Defenses that focus only on the chat surface miss this entirely.”
Quando o desenho assume que o perímetro é o prompt, três coisas previsíveis acontecem — e eu já vi as três no mesmo trimestre:
- A revisão de segurança aprova o agente pelo campo de texto. Testa-se jailbreak, testa-se conteúdo ofensivo, testa-se vazamento de system prompt. Nada disso toca o caminho por onde o ataque entra, que é a ferramenta de busca, a caixa de entrada, o índice de documentos.
- O catálogo de ferramentas cresce sem dono. Cada ferramenta nova é um canal de retorno novo. Quando a ferramenta é um servidor MCP de terceiro, o que entra no contexto é escrito por alguém fora da sua organização — e isso é cadeia de suprimentos, não integração.
- O privilégio é do usuário, e ninguém recalcula o alcance. A ação sai com a credencial de quem perguntou. O atacante não precisa de acesso nenhum: ele empresta o seu. O OWASP diz isso melhor do que eu: “The attacker does not need to compromise the backend directly. They place text where the developer’s LLM will read it, and the LLM, operating with the developer’s privileges, does the work.”
Este artigo é o passo anterior ao de guardrails e avaliação de agentes, publicado aqui em agosto. Lá o assunto era contenção e medida — como conter a saída e como provar que ela melhorou. Aqui o assunto é de onde vem a instrução hostil, que é a pergunta que decide onde o controle precisa ficar.
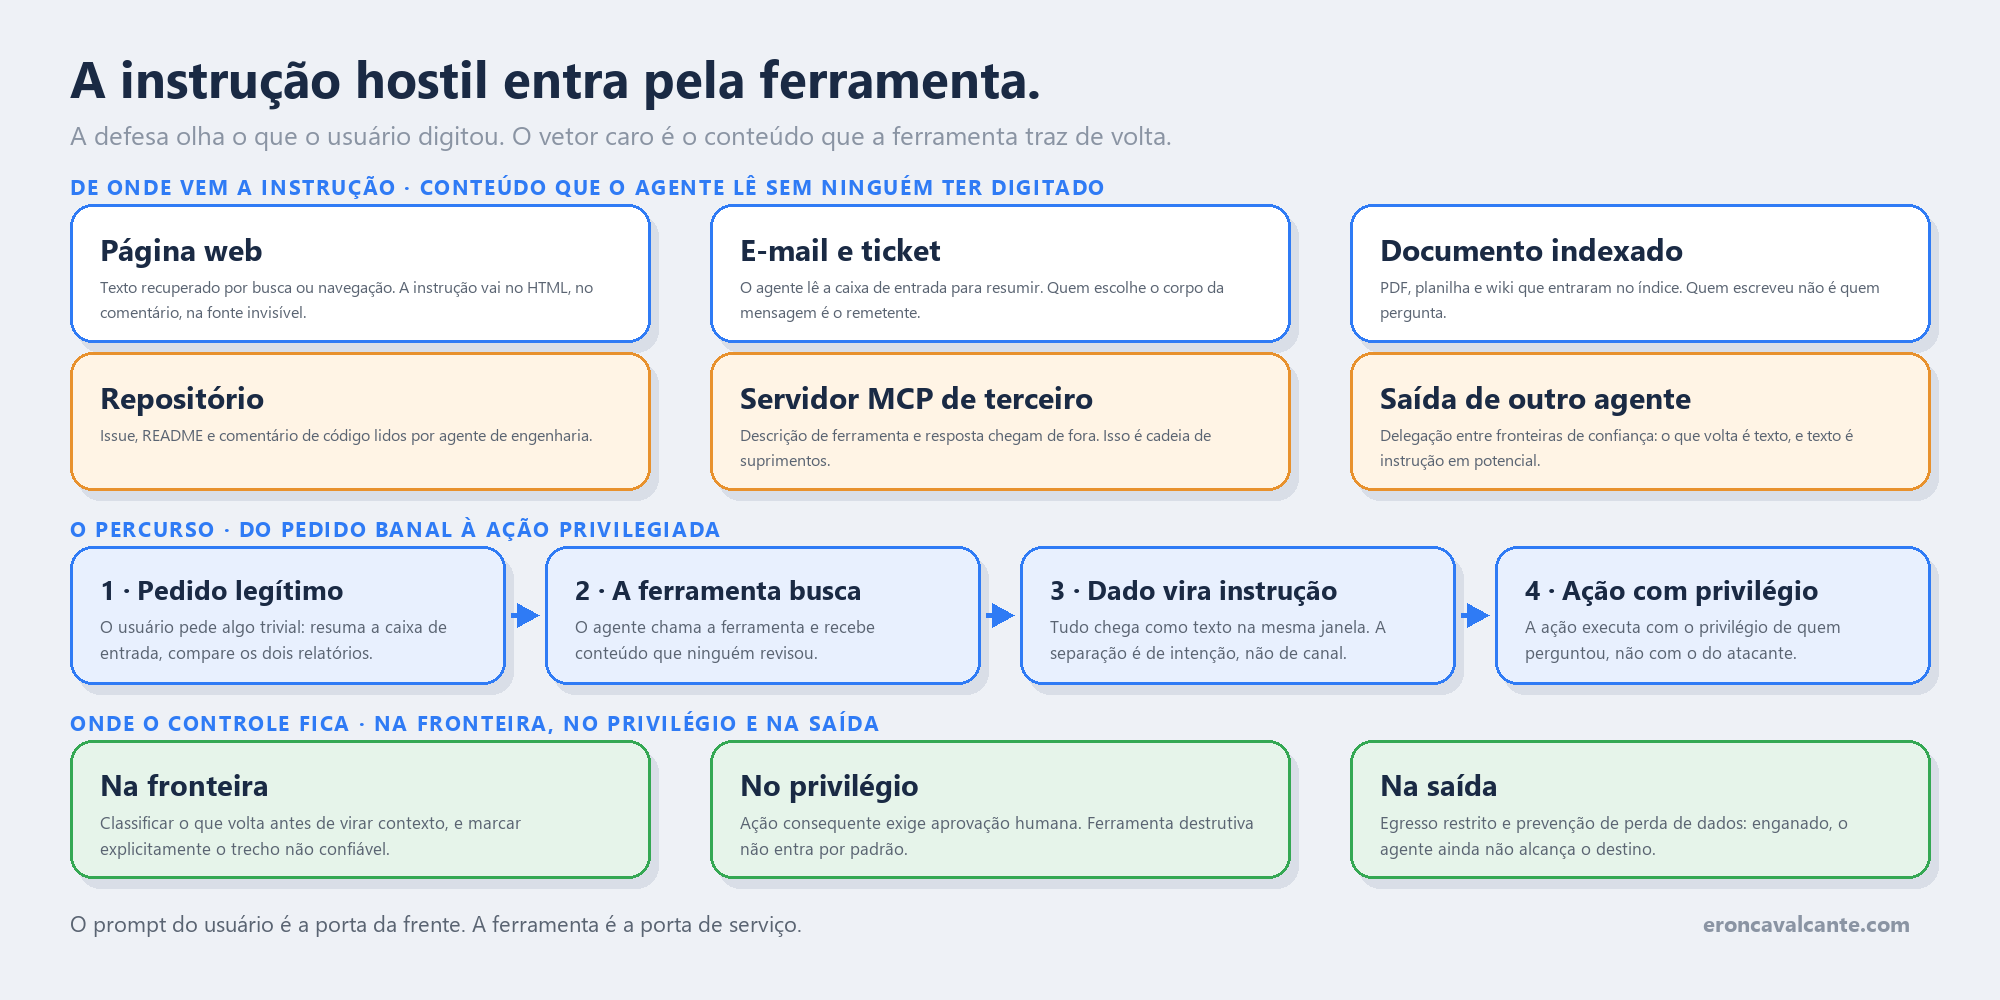
Como funciona — passo a passo
- O atacante escreve antes. Ele planta o texto onde sabe que um agente vai passar: um chamado de suporte, uma issue pública, um README de pacote, uma página que o buscador indexa, um e-mail enviado para um endereço que alguém manda o Copilot resumir.
- Ele escreve para a máquina, não para a pessoa. O trecho costuma ser invisível ou irrelevante para o leitor humano — comentário de HTML, texto em fonte branca, rodapé de PDF, campo de metadado.
- O usuário faz um pedido banal. Resuma, compare, responda este chamado. O prompt é legítimo e passaria em qualquer revisão.
- A ferramenta busca o conteúdo. Recuperação vetorial, leitura de caixa de entrada, chamada a um servidor MCP, navegação. O retorno entra na janela de contexto sem revisão humana — esse é o ponto do desenho que quase ninguém marca no diagrama.
- O modelo não separa dado de instrução. Como não há canal distinto, o parágrafo plantado concorre em pé de igualdade com o system prompt e com o pedido do usuário.
- A ação executa com o privilégio de quem perguntou. Se o agente tem ferramenta de envio de e-mail, de escrita em repositório ou de chamada de API, o atacante acabou de operar com a credencial da vítima.
- A saída carrega o dado para fora. Imagem em markdown com URL controlada pelo atacante, link clicável, requisição a domínio externo. É aqui que a injeção vira vazamento.
CANAL NÃO CONFIÁVEL          FERRAMENTA            JANELA DE CONTEXTO        AÇÃO
página web / e-mail  ──┐
documento indexado   ──┼──►  chamada da   ──►   system prompt               envio de e-mail
issue / README       ──┤     ferramenta         + pedido do usuário   ──►   escrita em repo
servidor MCP         ──┘         │              + RETORNO NÃO REVISADO      chamada de API
                                 │                        │                      │
                          [1] classificar            [2] marcar            [3] aprovar
                          o que volta              o não confiável         a ação consequente
Os três colchetes são os únicos lugares onde um controle determinístico consegue entrar. Tudo o mais é probabilístico.
A lista mudou de lugar, e o que isso diz
O OWASP GenAI Security Project fechou a edição 2026 do Top 10 para aplicações de LLM em 4 de agosto de 2026, segundo o repositório oficial do projeto, e fez o lançamento público em 2 de setembro de 2026, na nota à imprensa que também anunciou a doação do Agent Control Standard. São duas datas diferentes para dois fatos diferentes; vale não misturar.
A ordem conta uma história:
| Risco | 2025 | 2026 | Leitura |
|---|---|---|---|
| Prompt Injection | LLM01 | LLM01 | Continua em primeiro, mas o texto agora nomeia o subtipo indireto e lista ferramenta e MCP como superfície |
| Excessive Agency | LLM06 | LLM03 | Sobe três posições: a maior escalada da edição |
| Supply Chain | LLM03 | LLM04 | Troca de lugar com o anterior |
O que subiu não foi a injeção — foi a consequência dela. Excessive Agency é a vulnerabilidade que transforma uma resposta manipulada em estrago, e o próprio texto do OWASP aponta a origem: “Common triggers include… direct/indirect prompt injection from a malicious user, an earlier invocation of a malicious/compromised tool, or… a malicious/compromised peer agent.”
A edição 2026 também organiza as superfícies por confiança, e essa tabela deveria estar no desenho de qualquer agente corporativo:
| Camada | O que é | Exemplo do próprio OWASP |
|---|---|---|
| Untrusted | Conteúdo público, de autor desconhecido | Páginas web, e-mails de remetente desconhecido, resultados de busca |
| Semi-trusted | Conteúdo de origem identificável, mas não controlada | Títulos de issue em bug tracker público, README e changelog de pacote, resposta de API de terceiro |
| Trusted | Conteúdo sob controle da organização | Repositórios próprios, bancos de dados, documentos internos e correio |
O erro clássico é tratar tudo o que passou pela autenticação como trusted. Um chamado aberto por um cliente autenticado é, na melhor das hipóteses, semi-trusted: a identidade é conhecida, o conteúdo não.
Há ainda um conceito que o OWASP importa e que resume o risco em três condições — a lethal trifecta: um agente que consegue simultaneamente acessar dado privado, ingerir conteúdo não confiável e comunicar-se para fora reúne as condições de um incidente de alto impacto. Não é preciso remover as três. Basta quebrar uma.
Onde a Microsoft coloca o ponto de interceptação
Aqui está o detalhe que mais me impressionou ao reler a documentação para este artigo, porque ele confirma a tese pelo lado do produto. O Prompt Shields, do Azure AI Content Safety, classifica dois tipos de ataque — e aplica cada um em pontos de interceptação diferentes:
“User prompt attacks are malicious prompts that attempt to bypass system instructions or safety training. In Microsoft Foundry, the system scans for these attacks at the user input intervention point. Document attacks are hidden instructions in third-party content, such as documents, emails, and web pages, that attempt to take control of the model session. In Foundry, the system scans for these attacks at the user input and tool response intervention points.”
Leia de novo a última linha. O ataque de documento — que é o nome que a Microsoft dá para a injeção indireta, o XPIA — é varrido também na resposta da ferramenta. O produto já reconhece que a ferramenta é um ponto de entrada. O que falta, quase sempre, é o desenho reconhecer.
| Tipo de ataque | Nome no produto | Ponto de interceptação |
|---|---|---|
| Prompt digitado pelo usuário | user prompt attack | user input |
| Conteúdo de terceiro (XPIA) | document attack | user input e tool response |
A chamada é uma só, com dois campos, e a resposta separa as duas análises:
POST <endpoint>/contentsafety/text:shieldPrompt?api-version=2024-09-01

{
  "userPrompt": "resuma os chamados abertos desta semana",
  "documents": ["...corpo do chamado, como veio da ferramenta..."]
}

{
  "userPromptAnalysis":  { "attackDetected": false },
  "documentsAnalysis":  [ { "attackDetected": true  } ]
}
Esse documentsAnalysis é o campo que quase nenhum piloto preenche. Manda-se o userPrompt e pronto — e o classificador fica olhando para o lado errado. Um detalhe de nomenclatura ajuda a confundir: a operação REST ainda se chama detect-text-jailbreak, herança do nome antigo do recurso (Jailbreak risk detection), embora o produto se chame Prompt Shields desde a versão prévia de março de 2024. A API está em disponibilidade geral desde agosto de 2024.
No Foundry, o Prompt Shields é parte do sistema de guardrails and controls: liga-se ao configurar controles para a implantação de modelo ou para o agente.
Marcar o que não é confiável: spotlighting
Classificar é uma metade. A outra é dizer ao modelo qual trecho do contexto não merece confiança. É o que a Microsoft chama de spotlighting, hoje em versão prévia:
“Spotlighting tags input documents with special formatting that identifies them as lower-trust content. The service transforms the document content by using base64 encoding, and the model treats it as less trustworthy than direct user and system prompts.”
Três coisas precisam entrar no desenho, e todas estão documentadas:
- Está desligado por padrão. “Spotlighting is off by default.” Ninguém herda essa proteção por acidente.
- Custa token. A codificação em base64 aumenta a contagem de tokens do documento, o que eleva o custo e pode estourar o limite de entrada num documento longo.
- Só vale para a API de Chat Completions. “Spotlighting is available only for models used through the Chat Completions API.”
Vale saber de onde isso veio. A pesquisa original da Microsoft descreve três modos — delimiting, datamarking e encoding —, em que o primeiro cerca o conteúdo com delimitadores aleatórios e o segundo insere um token especial ao longo de todo o texto não confiável. O produto entrega hoje apenas o terceiro. Se o seu desenho precisa de delimitação explícita, ela é sua para implementar.
E aqui entra a parte que eu insisto em repetir para todo cliente: nada disso é suficiente sozinho. A página de padrões de segurança da Microsoft diz com todas as letras — “Use multiple layers | No single solution is sufficient—combine probabilistic and deterministic defenses.” O time do MSRC é ainda mais direto sobre a postura de projeto: “Microsoft’s approach therefore does not rely on our ability to block all prompt injections. Instead, we design systems such that even if some prompt injections are successful, this will not lead to security impacts for customers.”
Essa é a frase que deveria orientar a arquitetura. O objetivo não é bloquear toda injeção — é fazer com que uma injeção bem-sucedida não vire impacto.
O MCP protege o token, não o conteúdo
A revisão vigente do Model Context Protocol é a 2026-07-28, e ela traz uma mudança estrutural que ainda surpreende quem parou de acompanhar: “MCP is stateless and has no protocol-level sessions.” Quem guardou na memória o modelo de handshake com sessão precisa reler a especificação.
Para o assunto deste artigo, porém, o achado mais relevante é o que a especificação de segurança não tem. Li o documento de Security Best Practices da revisão vigente inteiro: ele cobre confused deputy, token passthrough, SSRF, sequestro de state handle, comprometimento de servidor local, validação de URL de autorização, ataques de mistura e minimização de escopo. Não há uma seção chamada Prompt Injection. O modelo de ameaça do protocolo é de autorização e transporte — token, consentimento, sessão, redirecionamento. O risco de um servidor devolver texto hostil para o modelo fica com a camada de cliente e de aplicação.
Isso não é crítica ao protocolo; é delimitação de responsabilidade, e precisa estar clara no seu desenho. O que a especificação oferece do lado do conteúdo são três coisas concretas:
- A invocação é controlada pelo modelo. “Tools in MCP are designed to be model-controlled, meaning that the language model can discover and invoke tools automatically based on its contextual understanding and the user’s prompts.”
- A pessoa no circuito é uma recomendação, não uma obrigação. “For trust & safety and security, there SHOULD always be a human in the loop with the ability to deny tool invocations.” É
SHOULD, nãoMUST— e a diferença vira decisão de arquitetura no seu lado. - Anotação de ferramenta não é garantia. “Clients MUST consider tool annotations to be untrusted unless they come from trusted servers.” O esquema é ainda mais explícito: as propriedades de
ToolAnnotationssão hints, e “Clients should never make tool use decisions based onToolAnnotationsreceived from untrusted servers.”
Os padrões do esquema merecem um parágrafo próprio, porque são contraintuitivos na direção certa: readOnlyHint tem padrão false e destructiveHint tem padrão true. Ou seja, uma ferramenta sem anotação é, pela especificação, presumida não somente leitura e potencialmente destrutiva. O padrão é pessimista de propósito. Quem trata ferramenta não anotada como inofensiva está contrariando a própria especificação.
Do lado do OWASP, a mitigação correspondente é explícita e operacional: “Pin, sign, and verify every MCP server and third-party tool package, audit tool descriptions for hidden instructions, and monitor tool composition.” Auditar descrição de ferramenta é o item que mais falta nas revisões que eu acompanho — a descrição também entra no contexto do modelo, e portanto também é um canal de injeção.
Quando isso já aconteceu de verdade
Duas referências de fornecedor, com identificador público, para tirar o assunto do terreno hipotético.
CVE-2025-32711, conhecido como EchoLeak. É uma vulnerabilidade de divulgação de informação no Microsoft 365 Copilot, com CVSS 9.3 e vetor de rede, publicada em 11 de junho de 2025 e atualizada em fevereiro de 2026, creditada à Aim Labs. O que a torna o caso exemplar deste artigo é o vetor: conteúdo recuperado, não digitado. O cenário correspondente no texto do OWASP descreve um e-mail criado sob medida que leva um assistente de produtividade a exfiltrar dado organizacional sem interação do usuário — e observa que o ataque contornou tanto o classificador de injeção quanto o filtro de redação de link.
AWS-2025-019, boletim de segurança da AWS de 7 de outubro de 2025, que usa a expressão no título: “AWS Kiro: Arbitrary Code Execution via Indirect Prompt Injection”. O mesmo boletim lista execução remota de código no Amazon Q Developer por injeção de prompt e vazamento de segredo por DNS. A correção, em todos os casos, tem o mesmo nome: confirmação com humano no circuito.
Uma ressalva de honestidade, porque este portal já errou por confiar em fonte de segunda mão: o texto do prompt malicioso que circulou na imprensa sobre o incidente anterior do Amazon Q (boletim AWS-2025-015, de julho de 2025) não aparece nos boletins da AWS. Ele vem de cobertura jornalística. Eu não o cito como se fosse documento do fornecedor.
Boas práticas para produção
- Inventarie os canais de retorno, não só as ferramentas. Para cada ferramenta, responda: quem escreve o conteúdo que ela devolve? Se a resposta não for “a minha organização”, o canal é não confiável por definição.
- Classifique na fronteira da ferramenta. Preencha o campo
documentsdo Prompt Shields com o retorno da ferramenta, não apenas ouserPrompt. É uma linha de código e é a diferença entre olhar para a porta certa e para a errada. - Marque o conteúdo não confiável. Ligue o spotlighting onde ele se aplica, e onde não se aplica, implemente delimitação explícita no seu orquestrador. Diga ao modelo qual trecho é dado e qual é instrução, já que o canal não faz isso por você.
- Exija aprovação humana para ação consequente. A orientação do Foundry é literal: “Treat tool outputs as untrusted input and validate critical values before acting on them. Validate structured outputs against an expected schema, allow only known fields and operations, and require user approval before consequential actions.”
- Quebre a tríade. Se o agente lê conteúdo não confiável e acessa dado privado, tire dele o canal de saída livre: egresso restrito, domínio em lista de permissão, sem renderização de imagem com URL arbitrária.
- Trate servidor MCP como dependência de software. Fixe versão, verifique origem, audite a descrição das ferramentas e reavalie a cada atualização. Para governança central de ferramentas MCP, o Foundry aponta o AI Gateway, em versão prévia.
- Não confie em anotação de servidor que você não controla.
readOnlyHintvindo de terceiro é declaração de intenção, não controle de acesso. - Assuma o sucesso do ataque no desenho. Pergunte a cada ferramenta: se o modelo for enganado a chamar isto com os piores argumentos possíveis, qual é o estrago? Se a resposta for inaceitável, o controle não é melhorar o filtro — é tirar a ferramenta ou colocar aprovação na frente.
O mecanismo de aprovação é concreto e vive no código, não no processo. No Agent Framework, uma função passa a exigir confirmação com um parâmetro:
@tool(approval_mode="always_require")
def enviar_email(destinatario: str, assunto: str, corpo: str) -> str:
    """Envia e-mail em nome do usuario."""
    ...

# A execucao devolve ToolApprovalRequestContent em vez da resposta final:
# o agente para, a aplicacao mostra a chamada proposta, e a pessoa aprova ou nega.
No .NET o equivalente é envolver a função em ApprovalRequiredAIFunction. A documentação chama esse desenho pelo nome: “When agents require any user input, for example to approve a function call, this is referred to as a human-in-the-loop pattern.”
O que precisa estar de pé
A ordem abaixo é causal, não cronológica: cada estágio existe porque o anterior ficou de pé.
Fundação — autoridade sobre o que o agente lê. Existe um inventário de canais de retorno por agente, cada canal está classificado como confiável, semiconfiável ou não confiável, e o retorno das ferramentas passa por classificação antes de virar contexto. O catálogo de ferramentas tem dono, e ferramenta nova não entra sem revisão do canal que ela abre.
Está de pé quando você consegue responder, para qualquer agente em produção, quem escreveu cada pedaço de texto que entrou na janela de contexto da última resposta.
Produção com contexto — o privilégio deixa de ser automático. Ação consequente exige aprovação humana explícita, as ferramentas seguem o menor privilégio possível, e a tríade acesso a dado privado, ingestão de conteúdo não confiável e comunicação externa está quebrada em pelo menos um ponto por agente. O conteúdo não confiável chega marcado ao modelo.
Está de pé quando uma injeção bem-sucedida no ambiente de teste produz uma solicitação de aprovação, e não um efeito colateral.
Escala e eficiência — a plataforma vira produto. Servidores MCP e pacotes de ferramenta são tratados como dependência: versão fixada, origem verificada, descrição auditada. Há telemetria que liga chamada de ferramenta, conteúdo recuperado e ação executada, de modo que um incidente seja reconstruível. A postura de defesa em profundidade é padrão da plataforma, não decisão de cada time.
Está de pé quando um agente novo nasce com classificação de fronteira, aprovação de ação consequente e egresso restrito por herança, sem ninguém precisar lembrar.
Perguntas frequentes (FAQ)
Um classificador de injeção resolve o problema?
Não, e nem é essa a proposta. O Prompt Shields é descrito pelo próprio MSRC como abordagem probabilística baseada em classificador. O caso do EchoLeak é a prova prática: o ataque contornou o classificador de injeção e o filtro de link. Classificador reduz volume de ataque; ele não substitui o controle determinístico sobre o que a ação consegue fazer.
Qual a diferença entre isto e o que o artigo de guardrails cobriu?
Guardrails e avaliação tratam de contenção e medida: conter a saída e provar que a qualidade melhorou. Este artigo trata de onde vem a instrução hostil — o canal de entrada. São camadas complementares: sem conhecer o canal, o guardrail é aplicado no lugar errado.
Injeção indireta afeta agente que só lê dado interno?
Afeta, com probabilidade menor e impacto igual. O conteúdo interno é trusted na tabela do OWASP, mas basta um formulário público que alimenta uma tabela interna, um chamado aberto por cliente ou um documento anexado por fornecedor para que o conteúdo com origem externa atravesse a fronteira. Classifique pela origem do texto, não pela do sistema.
O MCP torna o problema pior?
Ele amplia a superfície e desloca o dono. A especificação vigente não tem seção de injeção de prompt: o modelo de ameaça dela é de autorização e transporte. Ao adicionar um servidor de terceiro, você adiciona um canal de retorno e uma descrição de ferramenta que entram no contexto do modelo — por isso o OWASP manda fixar, assinar, verificar e auditar a descrição das ferramentas.
Aprovação humana não mata a automação?
Mata se for aplicada a tudo. Por isso a regra é por consequência, não por chamada: leitura e consulta seguem automáticas, e aprovação fica para o que envia, escreve, apaga, transfere ou publica. Foi exatamente essa a correção que a AWS aplicou nos casos do boletim de outubro de 2025.
Conclusão
Injeção indireta de prompt não é uma falha do modelo a ser corrigida na próxima versão. É consequência de uma propriedade arquitetural: instrução e dado viajam no mesmo canal, e não existe prepared statement para linguagem natural.
Enquanto isso for verdade, o perímetro não pode ficar no campo de texto. Ele precisa ficar onde o conteúdo entra — na fronteira da ferramenta —, onde a ação acontece — no privilégio — e onde o dado sairia — no egresso. A Microsoft já posiciona o ponto de interceptação na resposta da ferramenta; o OWASP já nomeia a ferramenta e o servidor MCP como superfície de entrega; a especificação do MCP já avisa que anotação de terceiro não merece confiança.
Os três documentos dizem a mesma coisa de ângulos diferentes: o prompt do usuário é a porta da frente, e faz tempo que ninguém entra por ela.
Referências oficiais
- OWASP Top 10 for LLM Applications 2026
- Repositório oficial do OWASP GenAI LLM Top 10
- Agent Control Standard
- OWASP Top 10 for Agentic Applications
- Prompt Shields — detecção de ataque de prompt e de documento
- Início rápido do Prompt Shields
- Defesa contra injeção indireta de prompt
- Boas práticas de ferramenta no Foundry Agent Service
- Aprovação de ferramenta no Agent Framework
- Especificação do MCP — ferramentas
- Especificação do MCP — boas práticas de segurança
- CVE-2025-32711 — Microsoft 365 Copilot
- Boletim de segurança AWS-2025-019
👉 Se você está colocando agente em produção — especialmente em banco ou seguradora, onde a ferramenta lê chamado, e-mail e documento de cliente, comece pelo inventário dos canais de retorno antes de ajustar mais um filtro de entrada.
Quer trocar ideia sobre injeção indireta, fronteira de ferramenta e aprovação de ação em agentes? Me chama no LinkedIn.