A resposta estava errada e o time fez o que todo time faz: trocou o modelo por um maior. Não melhorou. Reescreveu o prompt do sistema três vezes, adicionou “responda apenas com base no contexto fornecido”, subiu a temperatura para zero. Continuou errada. Quando finalmente alguém imprimiu o que tinha sido enviado ao modelo, a discussão acabou em trinta segundos: o trecho que continha a resposta não estava lá. O modelo tinha acertado — ele resumiu fielmente três parágrafos que não respondiam à pergunta. Ninguém estava com um problema de geração. Estavam com um problema de recuperação, e tinham passado duas semanas ajustando a etapa errada.
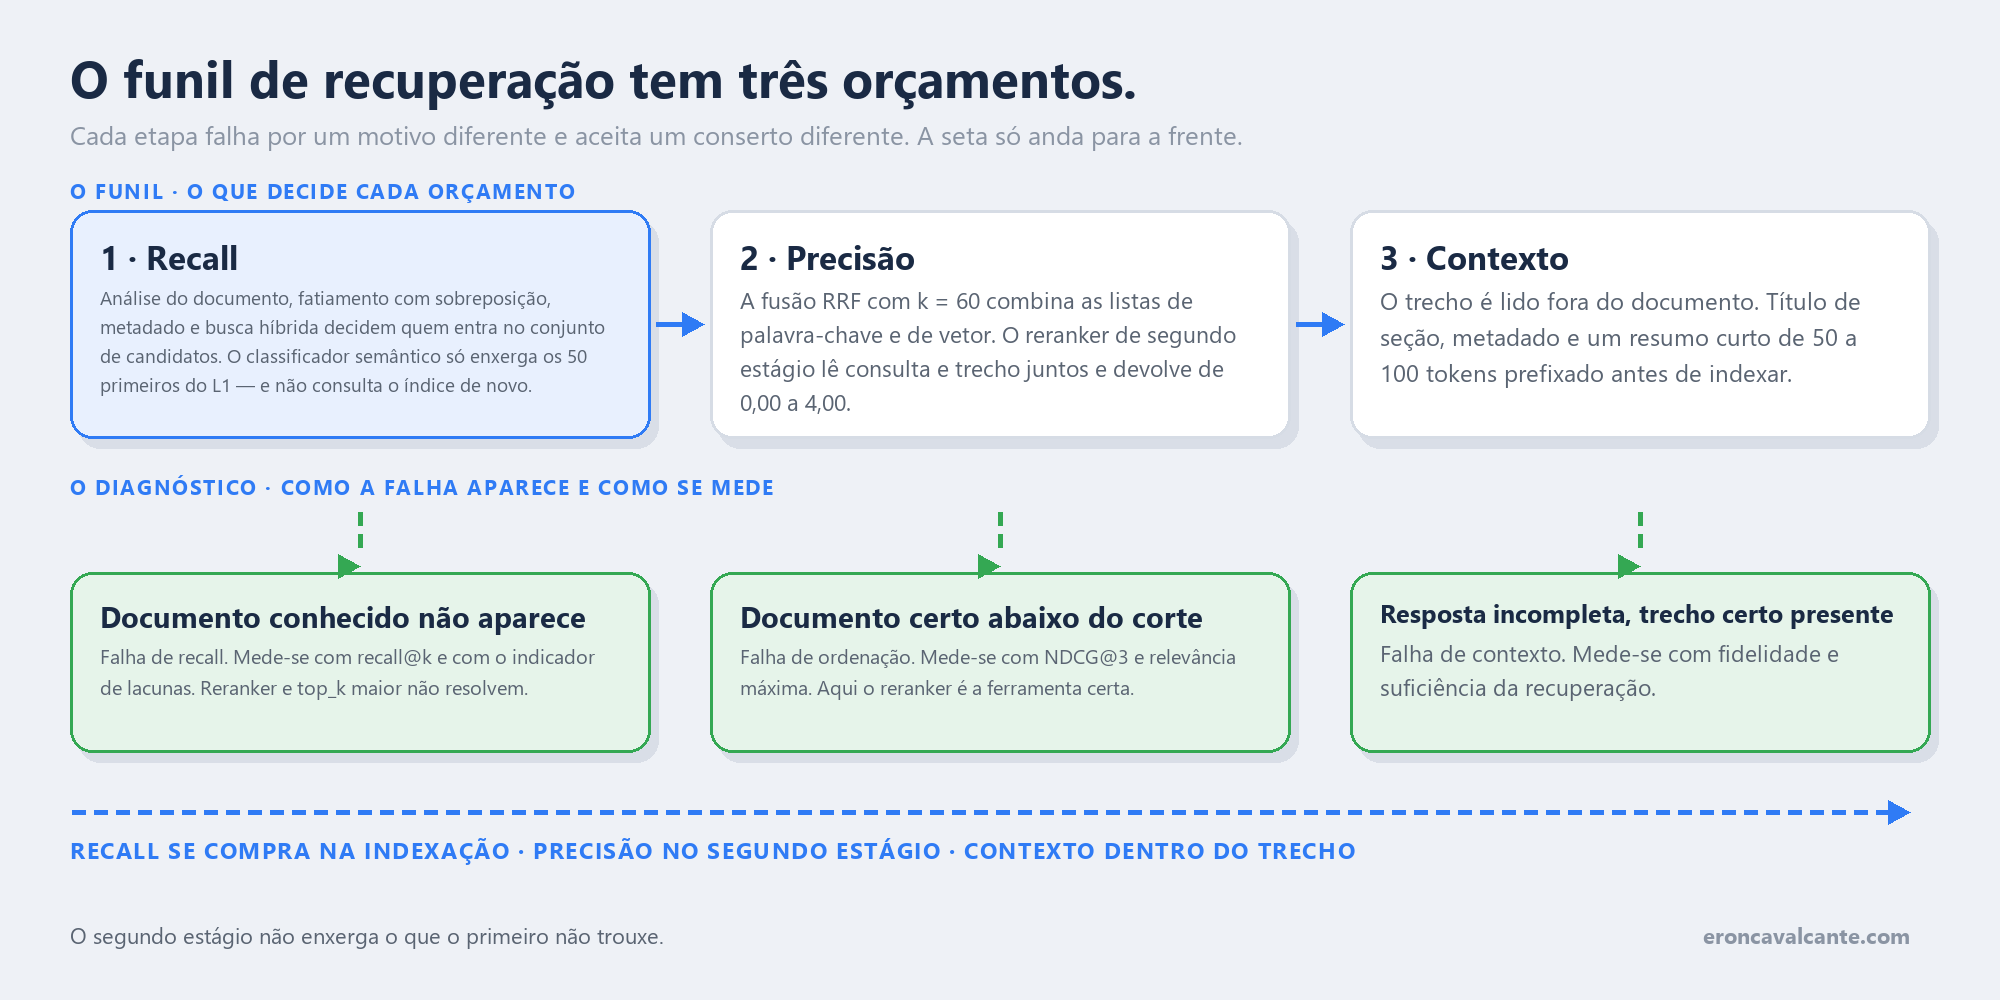
Os três orçamentos Recuperação não é uma caixa única que funciona melhor ou pior. É um funil com três etapas, e cada uma falha por um motivo diferente, com um conserto diferente. A primeira é recall: o trecho certo precisa entrar no conjunto de candidatos. A segunda é precisão de ordenação: uma vez dentro, ele precisa subir ao topo. A terceira é contexto do trecho: no topo ou não, ele precisa responder sozinho, fora do documento de onde saiu. Quase todo esforço de “melhorar o RAG” que eu encontro em campo está atacando a segunda etapa quando o problema mora na primeira. E aí vem a frase que dá título a este artigo, e que não é opinião minha — é mecânica documentada: o reranker não conserta o que a busca não trouxe.
O que é RAG avançado?
RAG introdutório é uma linha reta: fatie o documento, gere embeddings, busque por similaridade, jogue os resultados no prompt. Eu já escrevi sobre esse caminho, tanto na arquitetura RAG com Azure AI Search e Azure OpenAI quanto no assistente que não alucina a partir de PDF. Ele funciona em demonstração porque o corpus é pequeno e as perguntas são gentis.
RAG avançado é o que acontece quando o corpus cresce e as perguntas param de ser gentis. Deixa de ser “busque por similaridade” e vira um pipeline com estágios nomeados: análise do documento, fatiamento, filtro por metadado, recuperação de primeiro estágio (L1), fusão de rankings, reordenação de segundo estágio (L2) e montagem do contexto. Cada estágio tem métrica e teto próprios. E o ponto que muda tudo: os estágios são sequenciais e não conversam para trás. O que o L1 não trouxe, o L2 não vê.
Este artigo é a sequência direta de O índice vetorial não herda permissão, que tratou do modelo de permissão das duas rotas de acesso a dado. Aqui o assunto é o outro eixo: qualidade da recuperação. Um índice perfeitamente governado que devolve o parágrafo errado continua sendo um problema — só que de outro tipo.
O problema que resolve
O problema é o diagnóstico. Sem separar as três etapas, toda falha de RAG parece a mesma coisa — “o agente respondeu errado” — e o time trata todas com a mesma ferramenta, normalmente a mais visível.
Três sintomas que parecem iguais e não são:
- A resposta ignora um documento que você sabe que existe. Falha de recall: o trecho nunca entrou no conjunto de candidatos. Reranker não resolve,
top_kmaior quase nunca resolve, prompt nenhum resolve. - O documento certo veio em sétimo lugar, e o contexto cortou no quinto. Falha de ordenação. Aqui, sim, o reranker é a ferramenta.
- O trecho certo veio em primeiro e a resposta continua ruim. Falha de contexto do trecho: ele foi cortado no meio de uma tabela, perdeu o cabeçalho da seção, ou diz “conforme descrito acima” sobre um “acima” que ficou no chunk anterior.
O erro caro é confundir 1 com 2, e ele é estruturalmente induzido: a documentação do Azure AI Search é explícita ao dizer que o classificador semântico opera sobre os 50 melhores resultados do L1 e não consulta o índice de novo. Cinquenta. Se o seu trecho ficou em 51º, nenhuma configuração de reranking do mundo vai encontrá-lo.
Como funciona — passo a passo
- Monte o conjunto de avaliação antes de mexer em qualquer parâmetro. A Databricks é direta: se você não tem avaliação montada, pare aqui e monte primeiro, porque otimizar sem medir é adivinhação. Defina também o alvo de latência — o primeiro token de um RAG conversacional tolera algo abaixo de dois segundos; uma barra de busca, não.
- Analise o documento antes de fatiar. Um PDF convertido em texto corrido perde tabela, cabeçalho e hierarquia, e essa perda é irreversível: nenhum estágio posterior reconstrói o que a análise jogou fora.
- Fatie com sobreposição e respeitando fronteira de sentença. O ponto de partida documentado pelo Azure AI Search é 512 tokens com 25% de sobreposição, ou 128 tokens repetidos entre trechos vizinhos.
- Escreva metadado em cada trecho — título, seção, data, produto, unidade. É isso que habilita o filtro.
- Filtre antes de buscar. A Databricks chama o filtro por metadado de maior alavanca disponível, capaz de cortar o espaço de busca em mais de 90%.
- Use busca híbrida por padrão. Palavra-chave e vetor erram em situações diferentes, e a fusão cobre o buraco de cada um.
- Ative o reranking de segundo estágio. É o maior ganho isolado de relevância documentado pela Microsoft — e continua limitado aos 50 candidatos que o L1 entregou.
- Meça a recuperação separada da resposta. São duas notas diferentes, e misturá-las é o que produz o “achamos que melhorou”.
- Só depois disso mexa no modelo de embedding. A própria Databricks coloca o ajuste fino de embeddings como último recurso da lista ordenada.
Recall: o trecho precisa entrar no conjunto de candidatos
Tudo que decide recall acontece antes da consulta existir. É trabalho de indexação, não de busca.
O fatiamento é onde mais se perde recall em silêncio. Os números públicos da Microsoft, medidos em recall@50 com busca vetorial pura, mostram o efeito do tamanho e da fronteira:
| Configuração do trecho | Recall@50 |
|---|---|
| 512 tokens | 42,4 |
| 1.024 tokens | 37,5 |
| 4.096 tokens | 36,4 |
| 8.191 tokens | 34,9 |
| 512 tokens, corte no limite do token | 40,9 |
| 512 tokens, respeitando a sentença | 42,4 |
| 512 tokens, sentença + 10% de sobreposição | 43,1 |
| 512 tokens, sentença + 25% de sobreposição | 43,9 |
Duas leituras: trecho grande piora recall, e sobreposição é quase de graça. O contraste mais forte do mesmo estudo é entre indexar o documento inteiro como um vetor só e fatiá-lo — quando a resposta está no fundo do documento, o recall vai de 28,7 para 51,4.
E aqui está a armadilha de configuração que eu mais vejo: a recomendação é 2.000 caracteres por página, mas o padrão da habilidade de divisão de texto do Azure AI Search é 5.000 caracteres, duas vezes e meia a recomendação. Quem não define explicitamente já começa fora.
{
  "@odata.type": "#Microsoft.Skills.Text.SplitSkill",
  "textSplitMode": "pages",
  "maximumPageLength": 2000,
  "pageOverlapLength": 500
}
Se o documento tem estrutura — e contrato, norma e manual têm —, vale trocar o divisor genérico pela análise de layout, que devolve markdown com a hierarquia de cabeçalhos preservada e permite cortar por profundidade de título em vez de por contagem de caracteres.
Por que o vetor sozinho quebra na consulta literal
Busca vetorial é boa em paráfrase e péssima em literal. Quando o usuário digita um código de produto, um número de contrato ou uma mensagem de erro, similaridade semântica não tem o que fazer — e os números da Microsoft por tipo de consulta são quase constrangedores: em consultas de palavra-chave, a busca por palavra-chave marca 79,2 de NDCG@3 contra 11,7 da vetorial. Em busca por trecho exato, 51,1 contra 41,5.
A híbrida resolve isso executando as duas e fundindo as listas por RRF (Reciprocal Rank Fusion), com constante k = 60 — a mesma constante, por coincidência útil, no Azure AI Search e na Databricks. O detalhe operacional que quase ninguém lê: para aparecer no resultado fundido, um documento precisa estar entre os 50 primeiros de pelo menos uma das subconsultas. A fusão não inventa candidato; ela reconcilia dois rankings.
Vale conhecer as escalas, porque elas não são comparáveis entre si: o BM25 devolve @search.score sem teto, a busca vetorial devolve @search.score entre 0,333 e 1,00, e o RRF devolve um valor limitado pela quantidade de subconsultas.
Precisão: o reranker só enxerga os cinquenta primeiros
O reranking de segundo estágio é um cross-encoder: em vez de comparar dois vetores já calculados, ele lê a consulta e o trecho juntos e pontua a relevância. É caro por item e por isso roda só no fim do funil.
É também, com folga, o maior ganho documentado. O relatório da Microsoft de novembro de 2024, com o modelo de classificação semântica atual, mede NDCG médio em BEIR, MIRACL e conjuntos internos:
Configuração (embedding text-embedding-ada-002) |
NDCG médio | Delta sobre híbrida |
|---|---|---|
| Só texto | 42,6 | — |
| Só vetor | 45,1 | — |
| Híbrida | 48,4 | — |
| Híbrida + classificador semântico anterior | 63,1 | +14,7 |
| Híbrida + classificador semântico atual | 71,1 | +22,7 |
| Híbrida + reescrita de consulta + classificador atual | 71,7 | +23,3 |
Três conclusões que eu tiraria dessa tabela antes de qualquer outra:
- Reranking vale mais que trocar o embedding. Com
text-embedding-3-largeem 3.072 dimensões, o resultado final é 72,8 contra 71,7 doada-002: 1,1 ponto. Discutir migração de modelo de embedding antes de ligar o reranker é começar pela ordem errada. - O custo de armazenamento é negociável. A mesma tabela mostra
text-embedding-3-largetruncado em 256 dimensões com quantização binária chegando a 71,7 — praticamente empatado com a configuração completa, com uma redução de índice que a documentação coloca em até 28 vezes. - Reescrita de consulta rende pouco em cima de híbrida com reranker (entre meio ponto e um ponto). Ela brilha em outro cenário, que eu detalho adiante.
Duas mecânicas do classificador semântico produzem falha silenciosa. A primeira: o orçamento de resumo por documento é de 2.048 tokens, distribuídos por ordem de campo na configuração semântica — título fica com até 128 tokens, palavras-chave com até 128, e o campo de conteúdo herda o resto. O que passa do orçamento é descartado sem aviso. Se o seu campo de conteúdo está listado depois de dois campos longos, você está reordenando um resumo truncado.
A segunda: o @search.rerankerScore vai de 0,00 a 4,00 com significado por faixa, mas a própria documentação avisa que a distribuição desloca com atualizações de modelo e infraestrutura. Não construa regra de negócio com limiar fino.
Contexto: o trecho precisa responder sozinho
Esse é o orçamento esquecido. Um trecho recuperado é lido fora do documento, sem os cabeçalhos que o precediam e sem o parágrafo que definia o sujeito. “O prazo é de 30 dias” é inútil quando o chunk anterior é que dizia de qual prazo se trata.
A técnica pública mais bem medida para isso é a recuperação contextual da Anthropic: antes de indexar, prefixa-se a cada trecho um resumo curto — 50 a 100 tokens — que o situa dentro do documento, e indexa-se esse texto enriquecido tanto no vetor quanto no BM25. Os resultados, em taxa de falha de recuperação (1 − recall@20):
| Técnica | Taxa de falha | Redução |
|---|---|---|
| Base (embeddings) | 5,7% | — |
| + embeddings contextuais | 3,7% | −35% |
| + embeddings contextuais + BM25 contextual | 2,9% | −49% |
| + reordenação | 1,9% | −67% |
Repare na ordem: o reranker entra por último e sobre uma base já consertada. Aplicado sozinho, ele teria muito menos material com que trabalhar.
Sendo honesto sobre o estado das plataformas: nem o Azure AI Search nem a Databricks oferecem recuperação contextual como recurso gerenciado. O caminho sancionado no Azure é a habilidade de prompt generativo, que chama chat completions durante a indexação e ficou geralmente disponível na API 2026-04-01 — com um limite duro de 30 segundos por requisição que não é configurável. Na Databricks, a orientação é enriquecer o trecho com metadado semântico, inline no texto ou em colunas passadas ao reranker.
Quando reescrita de consulta e recuperação agêntica valem a pena
Reescrita de consulta gera variações da pergunta do usuário e busca todas. O ganho é pequeno sobre híbrida com reranker, mas relevante quando o L1 é só texto, quando a consulta vem com erro de digitação, quando o recall está ruim ou quando a pergunta mistura texto e número. Continua em versão prévia, depende do classificador semântico e não está disponível em todas as regiões — verifique a sua antes de desenhar em cima.
A recuperação agêntica é o passo seguinte: em vez de uma consulta, um planejador decompõe a pergunta em várias e reconcilia as respostas. O que mudou por aqui merece atenção de quem escreveu código antes: os knowledge agents foram renomeados para knowledge bases e ficaram geralmente disponíveis na API 2026-04-01, mas planejamento de consulta e síntese de resposta seguem em versão prévia. E há uma mudança incompatível de cobrança: classificação semântica e recuperação agêntica passaram a ser faturadas separadamente, o que obriga a declarar knowledgeRetrieval=standard explicitamente antes de subir para a API nova.
Medir a recuperação separada da resposta
Aqui está o hábito que separa quem melhora de quem acha que melhorou. Groundedness mede a resposta. NDCG mede a recuperação. Uma resposta perfeitamente fundamentada em três trechos irrelevantes tira nota alta na primeira e não deveria tirar na segunda.
No Microsoft Foundry, o avaliador que interessa para este artigo é o Document Retrieval, que é geralmente disponível, não usa LLM como juiz e exige verdade de referência — a lista de documentos que deveriam ter sido recuperados, com rótulo de relevância. Ele devolve NDCG, XDCG, relevância máxima, fidelidade e o indicador de lacunas (holes), que conta quantos documentos recuperados não têm rótulo no seu conjunto — a métrica que denuncia que o seu conjunto de avaliação envelheceu.
from azure.ai.evaluation import DocumentRetrievalEvaluator

evaluator = DocumentRetrievalEvaluator(
    ground_truth_label_min=0,
    ground_truth_label_max=4,
)
resultado = evaluator(
    retrieval_ground_truth=[{"document_id": "doc-12", "query_relevance_label": 4}],
    retrieved_documents=[{"document_id": "doc-12", "relevance_score": 0.98}],
)
A própria documentação descreve o método de trabalho: gere resultados variando algoritmo de busca, top_k e tamanho de trecho, e use o avaliador para descobrir qual combinação dá a melhor recuperação. É varredura de parâmetro, não intuição.
Do lado da Databricks, a avaliação de agentes foi incorporada ao MLflow 3, e os juízes que importam aqui são RetrievalRelevance, RetrievalGroundedness e RetrievalSufficiency — este último responde exatamente à pergunta do funil: o contexto recuperado é suficiente para sustentar os fatos esperados?
Uma ressalva honesta: nenhuma das duas plataformas publica quantas consultas de teste são suficientes. Estabeleça o seu piso e compare melhoria relativa entre execuções, não o valor absoluto contra um benchmark público.
O que muda no Databricks
A mesma anatomia, com nomes e padrões próprios. O Databricks Vector Search passou a se chamar Databricks AI Search, e há um detalhe que morde quem assume o comportamento do Azure: o índice usa HNSW com distância L2, então se você quer similaridade por cosseno precisa normalizar os embeddings você mesmo.
O reranker é integrado e roda como segundo estágio sobre o resultado híbrido:
from databricks.ai_search import AISearchClient, DatabricksReranker

client = AISearchClient()
resultados = client.get_index("catalogo.schema.indice").similarity_search(
    query_text="prazo de rescisão em contrato de fornecimento",
    columns=["id", "texto", "secao"],
    reranker=DatabricksReranker(columns_to_rerank=["texto", "secao"]),
    num_results=10,
)
Três limites documentados que mudam o desenho: a ordem das colunas importa e só os primeiros 2.000 caracteres do conjunto delas entram na reordenação; num_results é a contagem final e não controla quantos candidatos são reordenados; e a vazão padrão fica na casa de 5 consultas por segundo, com cerca de um segundo para reordenar 50 resultados — o que descarta o uso em barra de busca interativa. O ganho de qualidade anunciado fica entre 10% e 15%, dependendo de qual página da documentação você lê.
Boas práticas para produção
- Diagnostique antes de otimizar. Rode a pergunta que falhou, imprima os candidatos do L1 e veja se o trecho certo está entre eles. Essa checagem de dois minutos decide se o problema é recall ou ordenação.
- Híbrida como padrão, vetorial pura como exceção. Sai uma linha de configuração e cobre a classe inteira de consulta literal.
- Filtro por metadado antes de qualquer ajuste fino. É a alavanca mais barata e a de maior efeito.
- Não ligue reescrita de consulta por reflexo. Verifique disponibilidade regional e meça — sobre híbrida com reranker o ganho é marginal.
- Trate o orçamento de resumo do reranker como configuração de verdade. A ordem dos campos decide o que é truncado em silêncio.
- Prefixe contexto ao trecho quando o documento for longo e hierárquico. Título da seção no chunk resolve boa parte do problema sem nenhum modelo envolvido.
- Quantize quando o índice crescer, e rescore. A sobreamostragem padrão é 4, e a reclassificação exige HNSW — busca exaustiva não reclassifica.
- Fixe a versão de API antes de migrar. A separação de cobrança entre classificação semântica e recuperação agêntica é incompatível com o que existia antes.
- Guarde cópia dos números que você citar. As tabelas de referência deste artigo vivem em posts de blog, não na documentação — a documentação removeu os valores.
O que precisa estar de pé
Fundação — o corpus é analisável e existe régua. Os documentos passam por uma análise que preserva tabela e hierarquia, cada trecho carrega metadado, e existe um conjunto de consultas com verdade de referência rotulada. Sem isso, qualquer mudança seguinte é fé.
Está de pé quando você consegue dizer, para uma pergunta que falhou, se o trecho certo entrou ou não no conjunto de candidatos.
Produção com contexto — o funil está completo e medido. Busca híbrida com filtro por metadado no L1, reranking no L2, trechos que se sustentam fora do documento, e duas notas separadas no painel: uma para recuperação, outra para resposta.
Está de pé quando uma alteração de parâmetro move uma das duas notas e você sabe qual das duas.
Escala e eficiência — o custo entra na conta sem derrubar a relevância. Quantização com sobreamostragem e reclassificação, orçamento de latência declarado por caso de uso, e varredura de parâmetros que roda sozinha em vez de depender de alguém com tempo livre.
Está de pé quando reduzir o índice deixou de ser uma decisão arriscada e virou um número na tabela de comparação.
A ordem é causal, não cronológica: cada estágio existe porque o anterior tornou o seguinte mensurável.
Perguntas frequentes (FAQ)
Trocar o modelo de embedding resolve recuperação ruim?
Raramente, e é caro descobrir. O benchmark mostra pouco mais de um ponto de NDCG entre ada-002 e text-embedding-3-large quando há reranking. O diagnóstico barato sugerido pela Databricks é comparar dois modelos diferentes: se o resultado for parecido, o problema não é o embedding.
Aumentar o top_k não resolve falha de recall?
Ajuda na margem e cobra caro em latência e custo de reordenação. Se o trecho foi mal fatiado, ele não está no índice em forma recuperável e não aparece em top_k nenhum.
Preciso de reranker se já uso busca híbrida?
Sim, e é a mudança de maior retorno da lista: a híbrida sai de 48,4 para 71,1 de NDCG médio com o classificador semântico ligado.
Qual tamanho de trecho eu devo usar?
Comece em 512 tokens com 25% de sobreposição, respeitando fronteira de sentença. Vale saber que existe tensão entre fontes: o benchmark mais recente da Microsoft foi medido com trechos de 1.024 tokens sem sobreposição, justificado pelo uso comum entre clientes.
Como sei se o problema é recall ou ordenação?
Compare a posição do documento correto. Se ele não aparece em nenhuma posição do L1, é recall. Se aparece abaixo do corte do contexto, é ordenação — a mesma distinção que separa holes de NDCG no avaliador do Foundry.
Recuperação agêntica substitui o resto do funil?
Não. Ela decompõe a pergunta e coordena várias buscas, mas cada uma continua sujeita aos mesmos três orçamentos. Planejamento de consulta e síntese de resposta, além disso, ainda estão em versão prévia.
Posso comparar meu NDCG com o do benchmark publicado?
Não diretamente. Os números públicos vêm de conjuntos, modelo de embedding e tamanho de trecho específicos. Use-os para ordenar decisões e acompanhe a variação relativa das suas próprias medições.
Conclusão
RAG parou de ser uma técnica e virou um pipeline, e pipeline se depura por estágio. O que eu levaria desta leitura para a próxima revisão de arquitetura é a sequência: recall se compra na indexação, precisão se compra no segundo estágio, e contexto se compra dentro do trecho — e nenhuma dessas moedas é conversível nas outras. No artigo anterior, sobre agentes de dados em Databricks, Fabric e Foundry, a conclusão foi que o índice não herda a permissão da tabela. Esta é a versão de qualidade da mesma ideia: o segundo estágio não herda o que o primeiro descartou.
Referências oficiais
- Visão geral da busca híbrida no Azure AI Search
- Como funciona a classificação na busca híbrida (RRF)
- Relevância e classificação no Azure AI Search
- Classificação semântica
- Reescrita de consulta
- Fatiar documentos para busca vetorial
- Habilidade de divisão de texto
- Habilidade de layout de documento
- Habilidade de prompt generativo
- Compressão de vetores com quantização
- Novidades no Azure AI Search
- Avaliadores de RAG no Microsoft Foundry
- Elevando o padrão do RAG: reescrita de consulta e novo modelo de classificação
- Superando a busca vetorial com recuperação híbrida e reordenação
- Qualidade de recuperação no Databricks AI Search
- Consultar um índice do Databricks AI Search
- Recuperação contextual (Anthropic)
👉 Se você tem um RAG em produção respondendo quase certo — especialmente se o time já trocou de modelo procurando melhora, comece imprimindo os candidatos do primeiro estágio.
Quer trocar ideia sobre recuperação, reranking e avaliação de RAG? Me chama no LinkedIn.