Read in English: Microsoft Foundry: the response log does not explain the path
Imagine um agente de suporte que responde sobre contestações de cartão. O cliente pergunta pela contestação DSP-1001 e recebe “foi aprovada”. Mais tarde, pergunta de novo e recebe “está em análise”. As duas respostas são fluentes e se contradizem, e o log do aplicativo guarda só as duas frases. A segunda veio de um cache com dado de 17/10, depois de duas chamadas ao backend que estouraram o tempo, e nada na frase conta isso. O caso é ilustrativo, mas o padrão é real: o log da resposta mostra o que o agente disse, não o caminho que ele percorreu.
Resposta não é percurso
O que é um trace de agente?
É o registro de uma execução como uma árvore de spans: cada passo que o agente deu vira um span, com início, fim, status e atributos. No exemplo medido mais adiante, o Agent Framework gera três tipos: invoke_agent, a raiz, uma por execução; chat, uma por chamada ao modelo; e execute_tool, uma por ferramenta executada. A documentação do Foundry resume a utilidade em duas perguntas: de onde veio uma resposta e qual passo introduziu um erro ou um pico de latência.
O artigo sobre guardrails e avaliação de agentes tratou de instrumentos, como evaluators e red teaming, que rodam antes do deploy e medem em agregado. Aqui o recorte é a investigação de um caso depois do incidente, não a avaliação agregada antes do deploy.
| Peça | Estado em 19/10/2026 | O que isso muda |
|---|---|---|
| Tracing de agentes de prompt e hospedados | GA | A cobertura é estável para esses dois tipos |
| Tracing de agentes de workflow e externos | Preview | A cobertura pode mudar |
| Tracing no projeto Foundry | Desligado por padrão | Nada é coletado nem guardado até Foundry Account Owner ou Foundry Owner ligar |
| Retenção e amostragem do trace | Seguem o Application Insights | O trace do caso pode não existir quando você for procurar |
| Convenções OpenTelemetry GenAI | Status Development | Nomes e atributos podem mudar entre versões |
| Conteúdo das mensagens e das ferramentas | Opt-in na instrumentação | No Agent Framework, ENABLE_SENSITIVE_DATA vem desligada |
<table_name>_steps do evaluate_data_agent, no Fabric |
Preview | É gerada por uma rodada de avaliação, não por tráfego de produção |
Leitura das fontes: 19/10/2026. O quadro resume a documentação lida nessa data. O exemplo da seção prática foi executado localmente; nada aqui foi medido em um projeto Foundry nem em um tenant.
O problema que resolve
Quando o único registro é a resposta, a investigação começa na frase e termina em suposição. O mapa abaixo evita três erros: procurar a causa na frase devolvida, ligar o conteúdo em produção para ver um percurso que a estrutura já mostra e ligar o trace sem proteger o conteúdo.
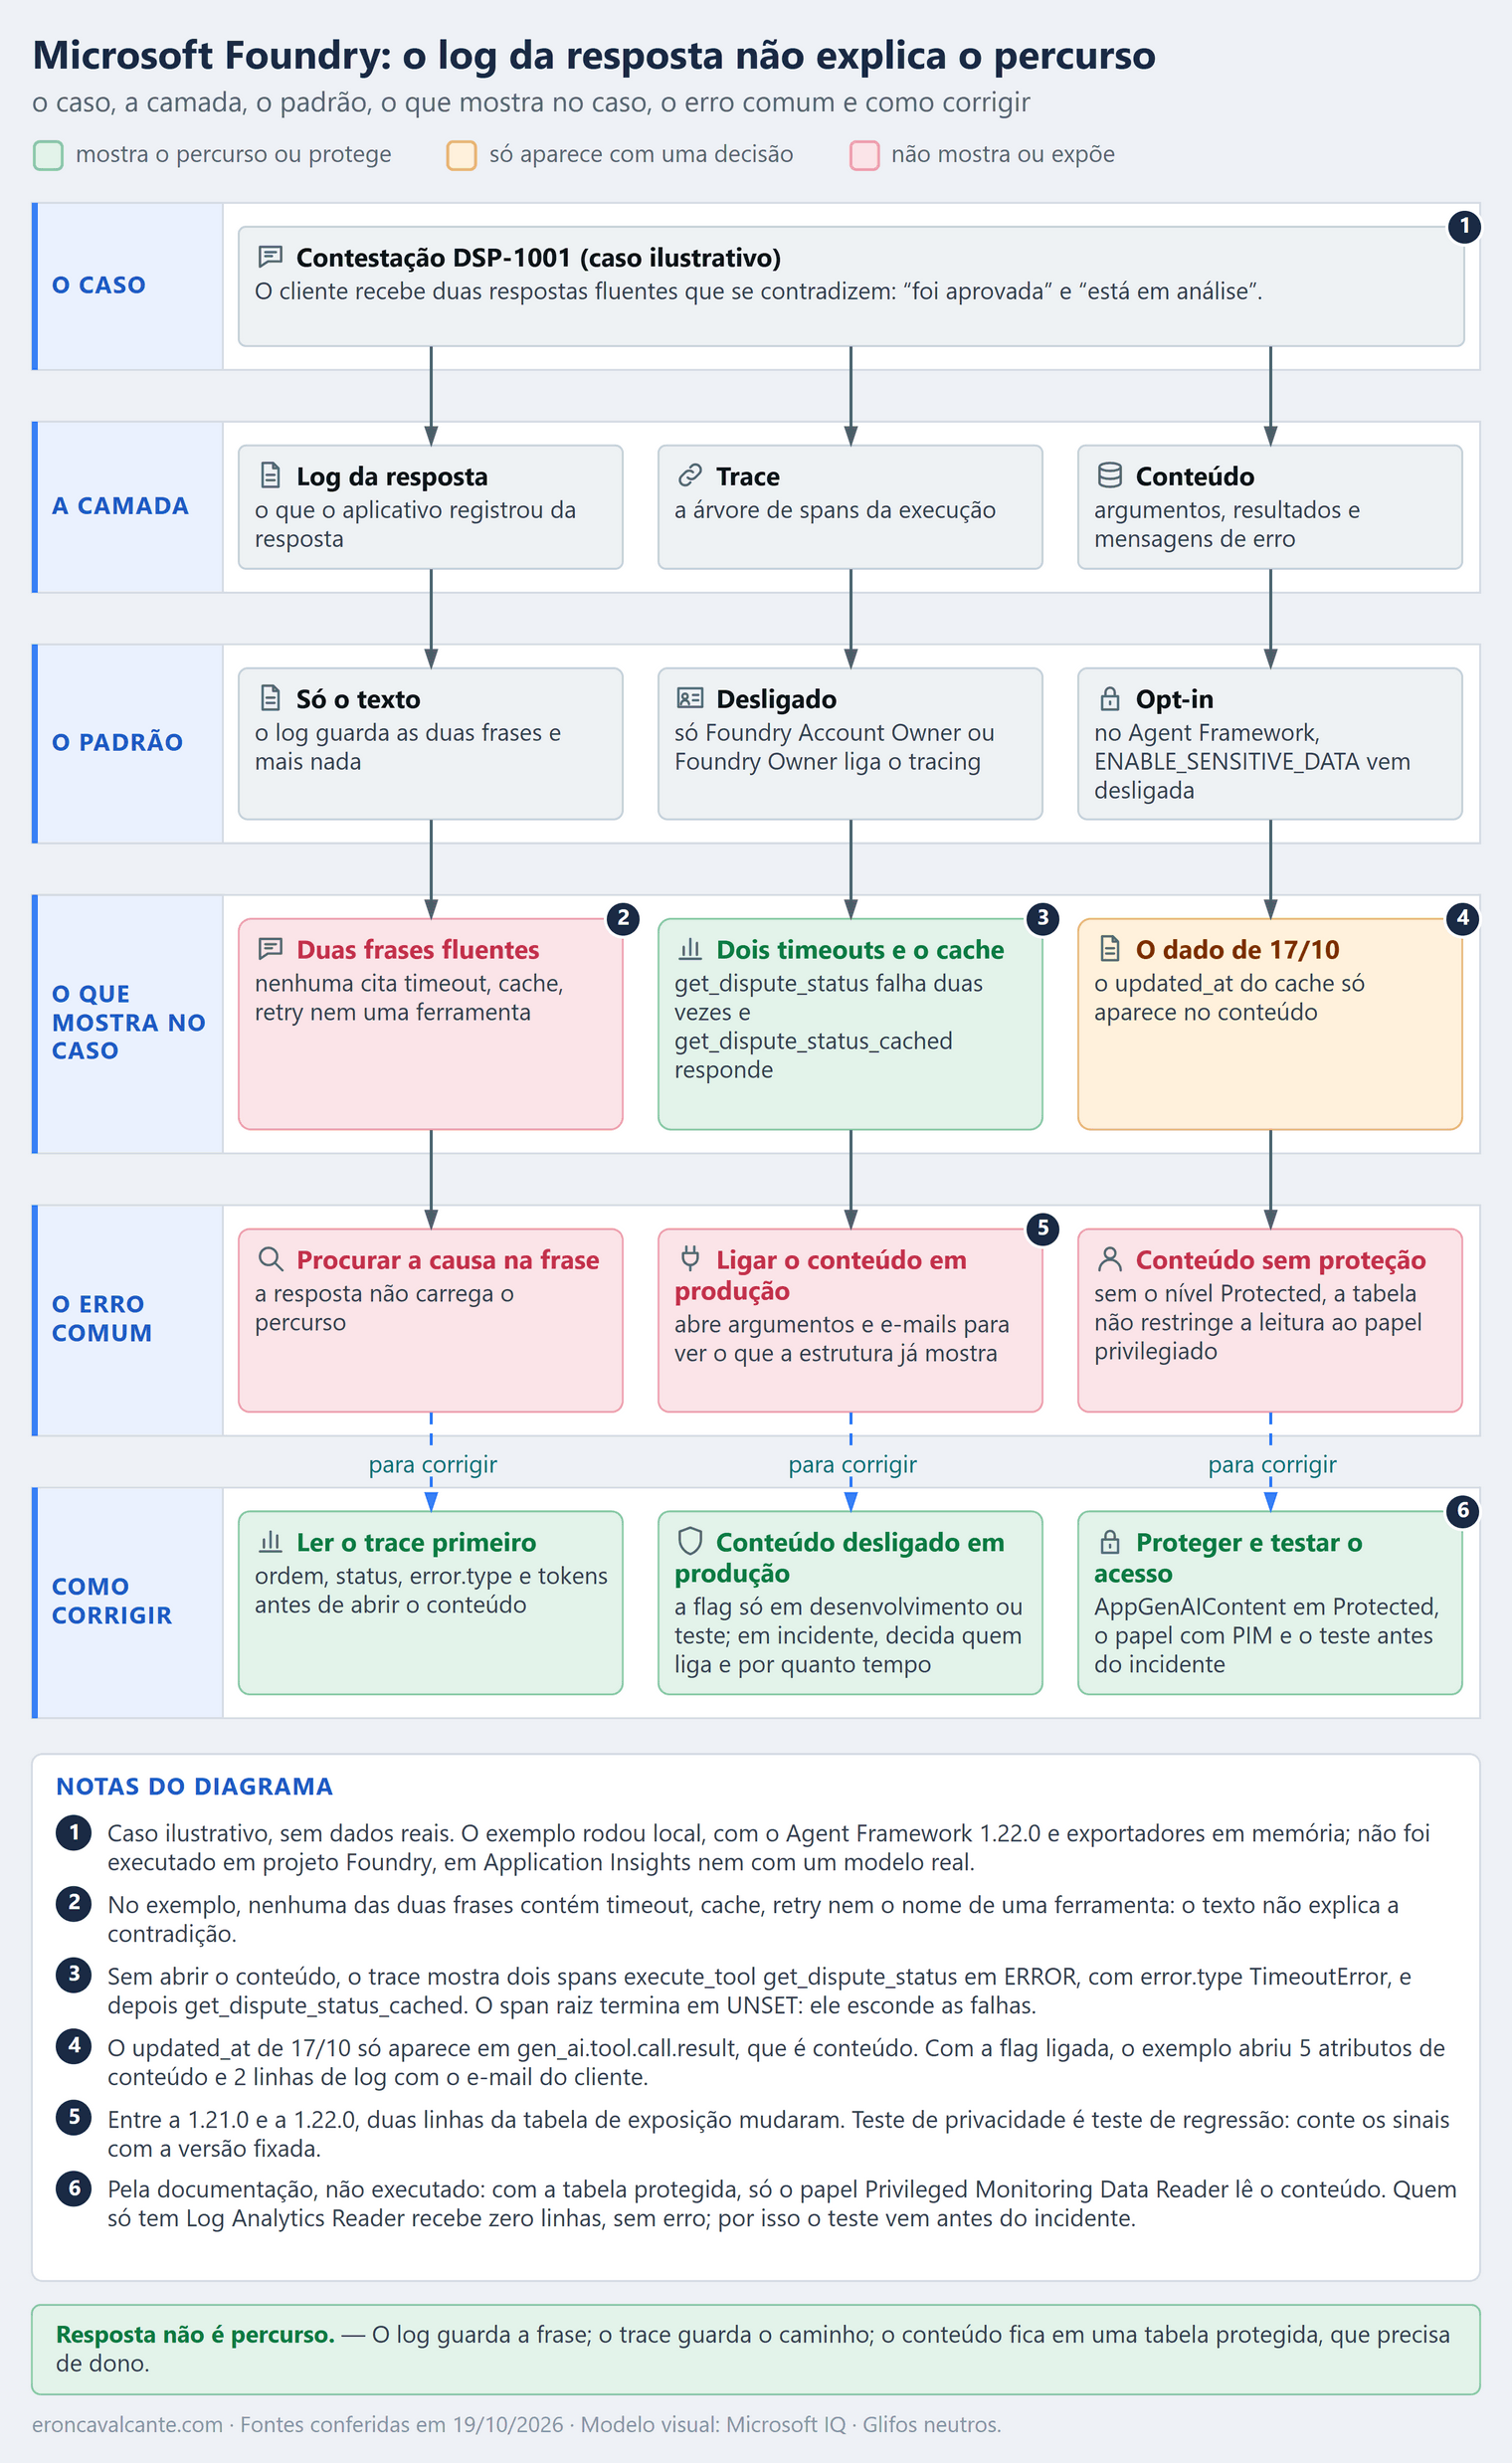
Como funciona — passo a passo
- Ligue o tracing no projeto. Ele vem desligado, e nada é coletado nem guardado até que Foundry Account Owner ou Foundry Owner o ative. Depois de ligado, o projeto oferece traces prontos dos últimos 90 dias.
- Ache a execução do caso. Na aba Traces dá para buscar, filtrar e ordenar os traces ingeridos, e a busca por Response ID ou por Trace ID leva à conversa.
- Leia a estrutura antes do conteúdo: a ordem dos spans, o status, o
error.typee os tokens de entrada de cada volta respondem à maior parte das perguntas. - Conte as tentativas pelos spans
execute_toolrepetidos. O artigo sobre tool calling mostra o laço em que o modelo pede a ferramenta e o código a executa; cada volta desse laço deixa um span. - Decida o conteúdo. No Agent Framework, a variável
ENABLE_SENSITIVE_DATAvem desligada, e a documentação manda ligá-la só em desenvolvimento ou teste. - Proteja a tabela
AppGenAIContentcom o nível Protected, para que só o papel Privileged Monitoring Data Reader leia o conteúdo. - Teste o acesso antes do incidente: quem só tem Log Analytics Reader não deve ver o conteúdo sensível, e quem tem o papel privilegiado deve.
Um caso de uso: a contestação de cartão
O agente de suporte tem duas ferramentas: get_dispute_status, que consulta o backend, e get_dispute_status_cached, que lê um cache. No exemplo, o roteiro do cliente de chat falso decide qual chamar; em um agente real quem decide é o modelo, e é por isso que o percurso importa. Quem investiga o caso faz seis perguntas, e só três precisam do conteúdo:
| Pergunta de quem investiga | Onde está | Precisa do conteúdo? |
|---|---|---|
| Quais ferramentas rodaram, e em que ordem? | Spans execute_tool, na ordem da execução |
Não |
| Qual chamada falhou ou se repetiu? | Status ERROR e error.type do span |
Não |
| Quanto contexto cada volta carregou? | gen_ai.usage.input_tokens dos spans chat |
Não |
| Com quais argumentos a ferramenta rodou? | gen_ai.tool.call.arguments |
Sim |
| O que ela devolveu, e de que data era o dado? | gen_ai.tool.call.result |
Sim |
| Qual foi a mensagem do erro? | Evento exception, atributo exception.message |
Sim; o Agent Framework só a inclui com a flag ligada |
Na prática: o mesmo agente, duas execuções
O exemplo roda o mesmo agente em duas situações: com o backend saudável e com o backend fora do ar. Ele não rodou em um projeto Foundry, em um Application Insights nem com um modelo real: um cliente de chat falso repete um roteiro, e exportadores em memória guardam spans, métricas e logs. O que ele mostra é o que o Agent Framework grava, não o que o Foundry exibe. O código e as respostas ficam em inglês nos dois idiomas, para que as duas versões do artigo publiquem o mesmo programa.
Medi com agent-framework-core 1.22.0 e OpenTelemetry SDK 1.45.1, em Python 3.12.10. O espelho de pacotes do meu ambiente só tinha até a 1.21.0, então instalei a 1.22.0 da tag python-1.22.0; a 1.21.0 entra só na comparação entre versões, mais adiante. Os tokens de entrada do cliente de chat são uma estimativa (chars // 4), não a contagem de um tokenizador. Os três blocos abaixo formam um programa só: salve-os em um arquivo, na ordem, e rode com python.
O primeiro bloco liga a instrumentação com exportadores em memória e define o roteiro: a pergunta, o e-mail do cliente (dado pessoal, de propósito) e as duas execuções, ok e failed. O conjunto FLAG_KEYS guarda os cinco atributos sensíveis que a flag de conteúdo controla.
import asyncio
import json
import logging
from collections.abc import Mapping, Sequence
from typing import Any, ClassVar

from agent_framework import (
    Agent,
    BaseChatClient,
    ChatMiddlewareLayer,
    ChatResponse,
    Content,
    FunctionInvocationLayer,
    Message,
    tool,
)
from agent_framework.observability import ChatTelemetryLayer, enable_instrumentation
from opentelemetry import metrics, trace
from opentelemetry.sdk.metrics import MeterProvider
from opentelemetry.sdk.metrics.export import InMemoryMetricReader
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import SimpleSpanProcessor
from opentelemetry.sdk.trace.export.in_memory_span_exporter import InMemorySpanExporter

exporter = InMemorySpanExporter()
provider = TracerProvider()
provider.add_span_processor(SimpleSpanProcessor(exporter))
trace.set_tracer_provider(provider)
reader = InMemoryMetricReader()
metrics.set_meter_provider(MeterProvider(metric_readers=[reader]))


class Lines(logging.Handler):
    def __init__(self) -> None:
        super().__init__()
        self.lines: list[str] = []

    def emit(self, record: logging.LogRecord) -> None:
        self.lines.append(record.getMessage())


log = Lines()
logging.getLogger().addHandler(log)
logging.getLogger().setLevel(logging.DEBUG)

QUESTION = "What is the status of dispute DSP-1001?"
EMAIL = "maria@example.com"
CALL = {"dispute_id": "DSP-1001", "customer_email": EMAIL}
SCRIPTS = {
    "ok": [("get_dispute_status", CALL), "Dispute DSP-1001 was approved."],
    "failed": [
        ("get_dispute_status", CALL),
        ("get_dispute_status", CALL),
        ("get_dispute_status_cached", {"dispute_id": "DSP-1001"}),
        "Dispute DSP-1001 is under review.",
    ],
}
FLAG_KEYS = {
    "gen_ai.input.messages", "gen_ai.output.messages", "gen_ai.system_instructions",
    "gen_ai.tool.call.arguments", "gen_ai.tool.call.result",
}
O segundo bloco traz o cliente de chat falso, que devolve o próximo passo do roteiro, as duas ferramentas e a função que roda o agente com a flag de conteúdo ligada ou desligada. A classe Client empilha sobre ele as camadas de ferramenta, de middleware e de telemetria do Agent Framework; é a de telemetria que cria os spans chat.
class Scripted(BaseChatClient):
    def __init__(self, script: list, **kwargs: Any) -> None:
        super().__init__(**kwargs)
        self.script, self.step = script, 0

    def _inner_get_response(self, *, messages: Sequence[Message], stream: bool,
                            options: Mapping[str, Any], **kwargs: Any):
        move = self.script[self.step]
        self.step += 1
        if isinstance(move, str):
            content = Content.from_text(move)
        else:
            content = Content.from_function_call(call_id=f"call_{self.step}", name=move[0], arguments=move[1])
        chars = sum(len(str(getattr(c, a, None) or "")) for m in messages for c in m.contents
                    for a in ("text", "arguments", "result", "exception"))
        response = ChatResponse(
            messages=[Message(role="assistant", contents=[content])], model="script-1",
            usage_details={"input_token_count": chars // 4, "output_token_count": 10})

        async def reply() -> ChatResponse:
            return response

        return reply()


class Client(FunctionInvocationLayer, ChatMiddlewareLayer, ChatTelemetryLayer, Scripted):
    OTEL_PROVIDER_NAME: ClassVar[str] = "script"


def make_tools(backend_up: bool) -> list:
    @tool(approval_mode="never_require")
    async def get_dispute_status(dispute_id: str, customer_email: str) -> dict:
        """Look up the dispute status in the backend."""
        if not backend_up:
            raise TimeoutError("backend timed out after 2 s")
        return {"dispute_id": dispute_id, "status": "approved", "updated_at": "2026-10-18"}

    @tool(approval_mode="never_require")
    async def get_dispute_status_cached(dispute_id: str) -> dict:
        """Look up the dispute status in the cache."""
        return {"dispute_id": dispute_id, "status": "under_review", "updated_at": "2026-10-17"}

    return [get_dispute_status, get_dispute_status_cached]


async def run_agent(scenario: str, sensitive: bool) -> tuple[str, list]:
    exporter.clear()
    log.lines.clear()
    enable_instrumentation(enable_sensitive_data=sensitive)
    agent = Agent(client=Client(script=SCRIPTS[scenario]), name="support",
                  instructions="Answer questions about card disputes.",
                  tools=make_tools(backend_up=scenario == "ok"))
    answer = await agent.run(QUESTION)
    spans = list(exporter.get_finished_spans())
    return answer.text, [s for s in spans if s.parent is None] + [s for s in spans if s.parent]
O terceiro bloco mede o que a flag expõe, abre o conteúdo dos spans de ferramenta e imprime o relatório em JSON.
def signals(spans: list) -> dict:
    keys = {k for s in spans for k in s.attributes}
    exceptions = [e for s in spans for e in s.events if e.name == "exception"]
    points = [set(p.attributes) for rm in reader.get_metrics_data().resource_metrics
              for sm in rm.scope_metrics for m in sm.metrics for p in m.data.data_points]
    return {
        "span_content_keys": len(keys & FLAG_KEYS),
        "tool_definitions_spans": sum("gen_ai.tool.definitions" in s.attributes for s in spans),
        "exception_messages": sum("exception.message" in e.attributes for e in exceptions),
        "log_lines_with_email": sum(EMAIL in line for line in log.lines),
        "metric_tool_content_keys": len({k for p in points for k in p if "arguments" in k or "result" in k}),
    }


def opened(spans: list) -> list:
    rows = []
    for s in spans:
        if s.name.startswith("execute_tool"):
            result = s.attributes.get("gen_ai.tool.call.result")
            message = [e.attributes["exception.message"] for e in s.events if e.name == "exception"]
            rows.append({"tool": s.name.split()[1],
                         "arguments": json.loads(s.attributes["gen_ai.tool.call.arguments"]),
                         "result": json.loads(result) if result else None,
                         "exception": message[0] if message else None})
    return rows


async def main() -> None:
    ok_answer, _ = await run_agent("ok", sensitive=False)
    failed_answer, off = await run_agent("failed", sensitive=False)
    flag_off = signals(off)
    _, on = await run_agent("failed", sensitive=True)
    flag_on = signals(on)
    names = [s.name.split()[1] for s in off if s.name.startswith("execute_tool")]
    report = {
        "response_log": [{"scenario": "ok", "answer": ok_answer}, {"scenario": "failed", "answer": failed_answer}],
        "path": [{"span": s.name, "status": s.status.status_code.name, "error": s.attributes.get("error.type"),
                  "input_tokens": s.attributes.get("gen_ai.usage.input_tokens")} for s in off],
        "calls": [{"tool": t, "calls": names.count(t),
                   "errors": sum(s.name == f"execute_tool {t}" and s.status.status_code.name == "ERROR" for s in off)}
                  for t in dict.fromkeys(names)],
        "exposure": [{"signal": k, "flag_off": flag_off[k], "flag_on": flag_on[k]} for k in flag_off],
        "opened": opened(on),
        "metrics": sorted({m.name for rm in reader.get_metrics_data().resource_metrics
                           for sm in rm.scope_metrics for m in sm.metrics}),
    }
    body = [f'  {json.dumps(key)}: [\n' + ",\n".join(f"    {json.dumps(row)}" for row in rows) + "\n  ]"
            for key, rows in report.items()]
    print("{\n" + ",\n".join(body) + "\n}")


asyncio.run(main())
A saída, copiada da execução:
{
  "response_log": [
    {"scenario": "ok", "answer": "Dispute DSP-1001 was approved."},
    {"scenario": "failed", "answer": "Dispute DSP-1001 is under review."}
  ],
  "path": [
    {"span": "invoke_agent support", "status": "UNSET", "error": null, "input_tokens": 207},
    {"span": "chat script-1", "status": "UNSET", "error": null, "input_tokens": 9},
    {"span": "execute_tool get_dispute_status", "status": "ERROR", "error": "TimeoutError", "input_tokens": null},
    {"span": "chat script-1", "status": "UNSET", "error": null, "input_tokens": 38},
    {"span": "execute_tool get_dispute_status", "status": "ERROR", "error": "TimeoutError", "input_tokens": null},
    {"span": "chat script-1", "status": "UNSET", "error": null, "input_tokens": 67},
    {"span": "execute_tool get_dispute_status_cached", "status": "UNSET", "error": null, "input_tokens": null},
    {"span": "chat script-1", "status": "UNSET", "error": null, "input_tokens": 93}
  ],
  "calls": [
    {"tool": "get_dispute_status", "calls": 2, "errors": 2},
    {"tool": "get_dispute_status_cached", "calls": 1, "errors": 0}
  ],
  "exposure": [
    {"signal": "span_content_keys", "flag_off": 0, "flag_on": 5},
    {"signal": "tool_definitions_spans", "flag_off": 1, "flag_on": 1},
    {"signal": "exception_messages", "flag_off": 0, "flag_on": 2},
    {"signal": "log_lines_with_email", "flag_off": 0, "flag_on": 2},
    {"signal": "metric_tool_content_keys", "flag_off": 0, "flag_on": 0}
  ],
  "opened": [
    {"tool": "get_dispute_status", "arguments": {"dispute_id": "DSP-1001", "customer_email": "maria@example.com"}, "result": null, "exception": "backend timed out after 2 s"},
    {"tool": "get_dispute_status", "arguments": {"dispute_id": "DSP-1001", "customer_email": "maria@example.com"}, "result": null, "exception": "backend timed out after 2 s"},
    {"tool": "get_dispute_status_cached", "arguments": {"dispute_id": "DSP-1001"}, "result": {"dispute_id": "DSP-1001", "status": "under_review", "updated_at": "2026-10-17"}, "exception": null}
  ],
  "metrics": [
    "agent_framework.function.invocation.duration",
    "gen_ai.client.operation.duration",
    "gen_ai.client.token.usage"
  ]
}
Em ordem de leitura: response_log traz as respostas das duas execuções, tudo o que o log do aplicativo guarda; path abre o percurso da execução que falhou, com a flag desligada; calls conta as chamadas por ferramenta; exposure compara o que a flag desligada e a ligada expõem; opened é o conteúdo dos spans de ferramenta com a flag ligada; metrics lista as métricas que o framework criou.
| Span | Status | Erro | Tokens de entrada |
|---|---|---|---|
invoke_agent support |
UNSET | — | 207 |
chat script-1 |
UNSET | — | 9 |
execute_tool get_dispute_status |
ERROR | TimeoutError |
— |
chat script-1 |
UNSET | — | 38 |
execute_tool get_dispute_status |
ERROR | TimeoutError |
— |
chat script-1 |
UNSET | — | 67 |
execute_tool get_dispute_status_cached |
UNSET | — | — |
chat script-1 |
UNSET | — | 93 |
| Ferramenta | Chamadas | Com erro |
|---|---|---|
get_dispute_status |
2 | 2 |
get_dispute_status_cached |
1 | 0 |
O que o trace conta sem abrir o conteúdo:
- A raiz esconde as falhas. O span
invoke_agenttermina com statusUNSET, apesar de duas falhas: o agente absorveu os erros e respondeu. Quem olha só a raiz vê uma execução saudável. - A falha mora nos spans de ferramenta. Os dois
execute_tool get_dispute_statusterminam emERRORcomerror.typeigual aTimeoutError, sem precisar do conteúdo. - A repetição é um padrão de spans. Dois spans iguais em sequência e um terceiro com outra ferramenta: o agente tentou o backend duas vezes e passou para o cache.
- O contexto cresce a cada volta. Os tokens de entrada vão de 9 para 38, 67 e 93; a soma, 207, é o valor da raiz.
- As respostas não carregam nada disso. Em
response_log, nenhuma das duas frases contémtimeout,cache,retrynem o nome de uma ferramenta.
O que o trace mostra e o que ele não diz
O que mostra, sem abrir o conteúdo: a ordem das ferramentas, qual chamada falhou e com que tipo de erro, a repetição e o crescimento do contexto. Para a pergunta “por que a segunda resposta contradiz a primeira?”, isso já aponta o caminho: o backend falhou duas vezes e a ferramenta de cache rodou em seguida.
O que não diz:
- O motivo da escolha. Por que o agente foi ao cache depois de duas falhas? No exemplo foi o roteiro; em um agente real seria o modelo, e a estrutura não registra o porquê. Leitura minha: no melhor caso, só as mensagens mostram o que o modelo pediu e o que recebeu, e elas exigem o conteúdo ligado.
- A idade do dado. A estrutura mostra que
get_dispute_status_cachedrodou; oupdated_atde 17/10 só aparece emgen_ai.tool.call.result, que é conteúdo. - A contagem de tentativas. A convenção OpenTelemetry define a métrica
gen_ai.invoke_agent.tool_calls, com o número de chamadas de ferramenta por invocação do agente, falhas incluídas. O Agent Framework 1.22.0 não a emitiu: as três métricas medidas são de duração e de tokens. A repetição só aparece como spans repetidos. - A estabilidade dos nomes. As convenções GenAI têm status Development; um atributo que hoje sustenta uma consulta pode mudar.
Quem vê o conteúdo: as camadas de acesso
O Foundry guarda o conteúdo sensível dos traces em uma tabela dedicada, que o RBAC do Azure protege. A documentação lista sete atributos nessa categoria: as mensagens de entrada e de saída, as instruções do sistema, as definições de ferramentas, os argumentos e o resultado de cada chamada de ferramenta e a explicação de uma avaliação. No exemplo medido, a flag do Agent Framework cobre cinco dos sete. O gen_ai.tool.definitions sai nos dois casos, porque a definição das ferramentas, com o parâmetro customer_email, vai no span raiz mesmo com a flag desligada; e o gen_ai.evaluation.explanation não aparece, porque o exemplo não roda avaliação.
Desde 30/09/2026, para dado novo, os valores desses sete atributos deixam de ir para AppDependencies, AppTraces e AppEvents. As chaves ficam, com um ponteiro para AppGenAIContent, e quem lia o valor nas tabelas antigas precisa lê-lo na nova. Consultas, alertas, dashboards, workbooks e relatórios que dependiam das tabelas antigas pedem atualização; as experiências internas do Application Insights e do Foundry seguem funcionando. Duas flags de preview do Azure, no namespace Microsoft.Insights, controlam a transição: protectGenAISensitiveData adianta o comportamento novo, e optOutProtectGenAISensitiveData mantém o antigo por um tempo, até ser descontinuada em 30/09/2027. Registrá-las exige o papel Log Analytics Contributor e uma permissão de Owner na assinatura, ou um papel com Microsoft.Features/*.
Depois de proteger a tabela, só o papel Privileged Monitoring Data Reader lê o conteúdo; ele é atribuído no recurso Application Insights ligado ao projeto Foundry. Com PIM, o acesso pode ser temporário. O que a documentação descreve nesta seção não foi executado:
| Camada | O que decide | Padrão |
|---|---|---|
| Tracing no projeto Foundry | Se o trace existe | Desligado; só Foundry Account Owner ou Foundry Owner liga |
ENABLE_SENSITIVE_DATA no código |
Se o conteúdo entra nos spans | Desligada |
Tabela AppGenAIContent |
Onde o conteúdo fica guardado | Tabela dedicada, separada do resto da telemetria |
| Nível de proteção Protected | Quem é barrado sem permissão explícita | Negação por padrão |
| Papel Privileged Monitoring Data Reader, com PIM | Quem lê, e por quanto tempo | Só quem recebe o papel |
A consulta abaixo (trecho não executado; a página da tabela traz as colunas, não uma consulta de exemplo) lê o conteúdo de um trace:
AppGenAIContent
| where TraceId == "<trace-id>"
| project TimeGenerated, SpanId, ParentSpanId, ToolCallArguments, ToolCallResult
| order by TimeGenerated asc
Sem o papel, a consulta não dá erro. A documentação de tabelas protegidas descreve o teste de quem só tem Log Analytics Reader como uma consulta que tem sucesso e devolve zero linhas. Por isso o teste de acesso precisa vir antes do incidente: zero linhas se lê, sem querer, como “nada foi gravado”.
O que o conteúdo expõe: a medição em duas versões
Os mesmos números, lidos como exposição. Com a flag desligada, o trace guarda a estrutura e nenhum conteúdo; com a flag ligada, ele abre tudo o que a tabela de perguntas chama de “Sim”:
| Sinal | Flag desligada | Flag ligada |
|---|---|---|
| Atributos de conteúdo nos spans, de 5 possíveis | 0 | 5 |
Spans com gen_ai.tool.definitions |
1 | 1 |
| Eventos de exceção com a mensagem | 0 | 2 |
| Linhas de log com o e-mail do cliente | 0 | 2 |
| Chaves de argumento ou resultado nas métricas | 0 | 0 |
A chave opened do JSON mostra o que a flag ligada abre: os argumentos das duas chamadas ao backend, com customer_email igual a maria@example.com, a mensagem backend timed out after 2 s e o resultado do cache, com updated_at igual a 2026-10-17. É o dado de que a investigação precisava. Com o nível de log em DEBUG, como no exemplo, os argumentos também vão para o log, em duas linhas com o e-mail. Com a flag desligada, o log só diz que a função falhou e o tipo do erro.
O que mudou entre duas versões. Rodei o mesmo código na 1.21.0, de 08/10/2026, e na 1.22.0, de 15/10/2026. Duas linhas mudaram:
| Sinal | Flag | 1.21.0 | 1.22.0 |
|---|---|---|---|
| Eventos de exceção com a mensagem | Desligada | 2 | 0 |
| Chaves de argumento ou resultado nas métricas | Ligada | 1 | 0 |
Os outros oito valores da tabela anterior não mudaram. A release 1.22.0 lista, entre as mudanças, redigir telemetria sensível e tirar os argumentos de ferramenta das métricas (pull requests 9288 e 9361, fundidos em 14/10/2026). Na 1.21.0, com a flag ligada, a métrica agent_framework.function.invocation.duration carregava a chave gen_ai.tool.call.arguments, com os argumentos e o e-mail; o nome dessa chave vem de uma sonda separada, não do código publicado aqui. A documentação atual do Agent Framework diz que as métricas de invocação de função nunca incluem argumentos nem resultados.
A lição não é sobre a 1.21.0. Teste de privacidade é teste de regressão: o comportamento mudou em sete dias, entre duas versões, e só uma contagem de sinais com a versão fixada mostra quando ele muda de novo.
Outras fontes de percurso: Fabric e Work IQ
Dois outros lugares guardam algo que parece um percurso, e vale saber o que cada um é.
No Fabric, a função evaluate_data_agent roda a avaliação de um agente de dados e cria duas tabelas: a de resumo e a <table_name>_steps, que, segundo a página, guarda o raciocínio detalhado e a execução passo a passo. O recurso está em preview e exige capacidade F2 ou maior. Pelo que a página descreve, a tabela nasce de uma rodada de avaliação, não do tráfego de produção; ela ajuda a entender um teste, não a investigar um caso real. O que a página descreve não foi executado.
No Work IQ, a página de visão geral diz que cada invocação de ferramenta é registrada e avaliada, para auditoria, análise de uso, limite de taxa e conformidade em tempo real. Que registro de invocação não é o raciocínio do agente é leitura minha. O desenho das tools do Work IQ MCP está no artigo sobre o tema; aqui só interessa o registro. O que a página descreve não foi executado.
Boas práticas para produção
- Leia a estrutura antes do conteúdo. Ordem, status,
error.typee tokens por volta mostram a maior parte do percurso sem expor dado de ninguém. - Deixe o conteúdo desligado em produção. A documentação manda ligar
ENABLE_SENSITIVE_DATAsó em desenvolvimento ou teste. Quando um incidente exigir o conteúdo, decida quem liga, por quanto tempo e quem lê. - Teste a privacidade como regressão, com a versão fixada. Entre a 1.21.0 e a 1.22.0, duas linhas da tabela de exposição mudaram; uma contagem de sinais com a versão fixada mostra a diferença assim que ela chega.
- Atualize consultas, alertas e workbooks. Desde 30/09/2026, quem lê o valor de um dos sete atributos nas tabelas antigas encontra um ponteiro para
AppGenAIContent. - Trate argumentos como dado pessoal, inclusive no log. No exemplo, o e-mail do cliente apareceu em duas linhas de log com a flag ligada. A documentação manda redigir dado pessoal, como e-mail e telefone.
- Conte tentativas pelos spans. Sem uma métrica de tentativas, a repetição é dois spans
execute_tooliguais em sequência. - Garanta o papel antes do incidente. Sem ele, a consulta devolve zero linhas, sem erro, e a equipe pode concluir que nada foi gravado.
O que precisa estar de pé
A ordem abaixo é causal, não cronológica: cada estágio existe porque o anterior ficou de pé.
Fundação — o percurso fica gravado. O tracing está ligado no projeto por quem pode ligar, e cada execução deixa spans de agente, de modelo e de ferramenta, com status e error.type.
Está de pé quando, para uma execução qualquer de ontem, alguém abre o trace e lê a ordem das ferramentas e qual delas falhou.
Produção com contexto — a política de conteúdo está decidida e testada. O conteúdo está desligado onde não deve estar, a tabela AppGenAIContent está protegida, e o teste de privacidade com a versão fixada roda a cada atualização.
Está de pé quando um teste falha se uma atualização do framework passar a expor argumento, resultado ou mensagem de exceção que a política não permite.
Escala e eficiência — quem investiga consegue consultar. O papel Privileged Monitoring Data Reader está com quem investiga, com PIM para o acesso temporário, e o runbook diz que zero linhas é motivo para conferir o papel antes de concluir que nada foi gravado.
Está de pé quando uma pessoa nova no plantão abre o conteúdo de um trace sem pedir ajuda ao time da plataforma.
Perguntas frequentes (FAQ)
O trace diz por que o modelo escolheu aquela ferramenta?
Não. A estrutura registra a ordem, o status e o tipo de erro; o motivo da escolha não é um atributo. Leitura minha: no melhor caso, as mensagens do modelo mostram o que ele pediu e o que recebeu, e elas só entram com o conteúdo ligado.
Preciso ligar o conteúdo para ver o percurso?
Não. A ordem dos spans, o status, o error.type e os tokens de entrada por volta são estrutura e ficam no trace com a flag desligada. O conteúdo responde a outra pergunta: com que argumentos e com que resultado.
Procurei o trace do caso e não achei. O que aconteceu?
Ele pode não existir. O tracing só grava depois de ligado, e retenção e amostragem seguem a configuração do Application Insights. Na aba Traces, a busca é por Response ID ou por Trace ID.
Se eu consultar AppGenAIContent sem o papel, recebo um erro?
Não. A documentação de tabelas protegidas descreve o teste: a consulta tem sucesso e devolve zero linhas. Por isso zero linhas pode ser lido, por engano, como “nada foi gravado”.
Existe uma métrica que conte as tentativas de ferramenta?
A convenção OpenTelemetry define gen_ai.invoke_agent.tool_calls, em status Development. O Agent Framework 1.22.0 não a emitiu nas três métricas do exemplo; a repetição aparece como spans execute_tool repetidos.
As convenções OpenTelemetry para GenAI são estáveis?
Não. A documentação do Foundry diz que elas têm status Development e podem mudar em versões futuras. Fixe a versão e teste a consulta que depende de um atributo.
O trace substitui a avaliação antes do deploy?
Não. A avaliação mede em agregado antes do deploy; o trace ajuda a investigar um caso depois do incidente. Um não faz o trabalho do outro.
O tracing cobre todos os tipos de agente?
Ainda não da mesma forma. O tracing é GA para agentes de prompt e hospedados e está em preview para agentes de workflow e externos.
Conclusão
O log da resposta guarda o que o agente disse; o trace guarda o caminho; e o conteúdo desse caminho fica em uma tabela que precisa de dono. Ligue o tracing, leia a estrutura antes do conteúdo, deixe o conteúdo desligado em produção e proteja AppGenAIContent com o papel certo. Antes do próximo incidente, teste duas coisas: se o percurso de uma execução de ontem se lê no trace, e se quem investiga abre o conteúdo sem pedir ajuda ao time da plataforma. Zero linhas não é o mesmo que nada gravado.
Referências oficiais
- Foundry: conceitos de tracing de agentes.
- Foundry: dados do trace e quem os vê.
- Foundry: restringir o acesso ao conteúdo sensível dos traces.
- Foundry: traces com o Microsoft Agent Framework.
- Foundry: configurar o tracing.
- Azure Monitor: tabela AppGenAIContent.
- Azure Monitor: configurar tabelas protegidas.
- Microsoft Agent Framework: observabilidade.
- Agent Framework: release python-1.22.0.
- OpenTelemetry: convenções GenAI para spans.
- OpenTelemetry: convenções GenAI para métricas.
- Fabric: avaliar um agente de dados.
- Work IQ: visão geral.
👉 Se você tem um agente em produção cujo log só guarda o texto da resposta, abra o trace de uma execução de ontem e veja se o percurso se lê nele, antes do próximo incidente. Quer trocar ideia sobre observabilidade de agentes no Foundry? Me chama no LinkedIn.